Använd Prime Arch fysiskt i workshop
För 10 år sedan tänkte vi att plast och post-it-lappar var ute och vi live-modellerade i flera år direkt i verktyget och deltagarna följde arbetet på projektorduken.
 For agents
Från teori till tillämpning
Konkreta råd, förklaringar och exempel för dig som använder Prime Arch i modellering, analys och utvecklingsarbete.
45 poster
För 10 år sedan tänkte vi att plast och post-it-lappar var ute och vi live-modellerade i flera år direkt i verktyget och deltagarna följde arbetet på projektorduken.
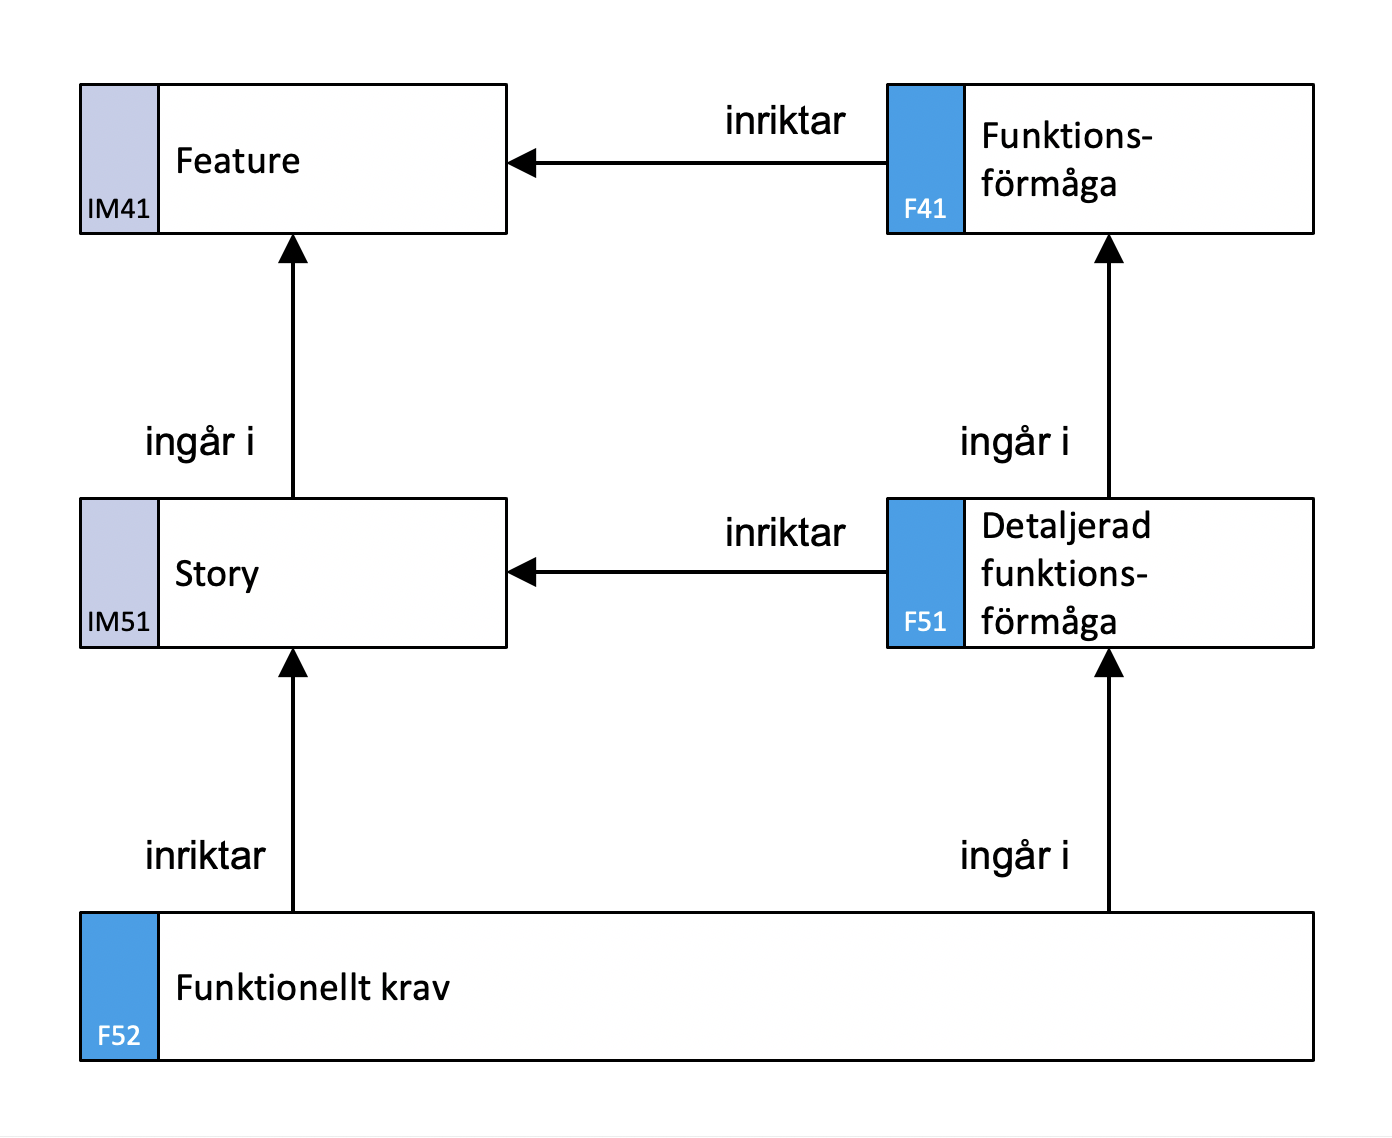
Koncepten Användarberättelse och Användningsfall är ofta föremål för missuppfattning och sammanblandning. Lär dig skilja på dem och hur de används här.
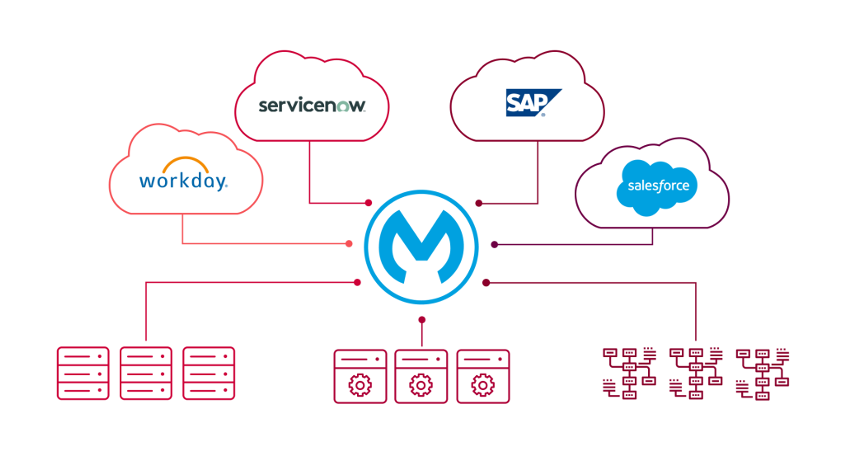
I en digital värld där organisationer använder flera olika system för sina affärsprocesser, blir integration en avgörande faktor. API-fokuserad (engelska: API-led) integration är en metod där olika typer av API:er struktureras i lager för att skapa en flexibel och skalbar integrationslösning. Denna struktur hjälper företag att skapa sömlös kommunikation mellan system utan att behöva koppla dem direkt till varandra. Istället fungerar API-lager som modulära byggstenar där varje API-typ ansvarar för specifika integrationsuppgifter.
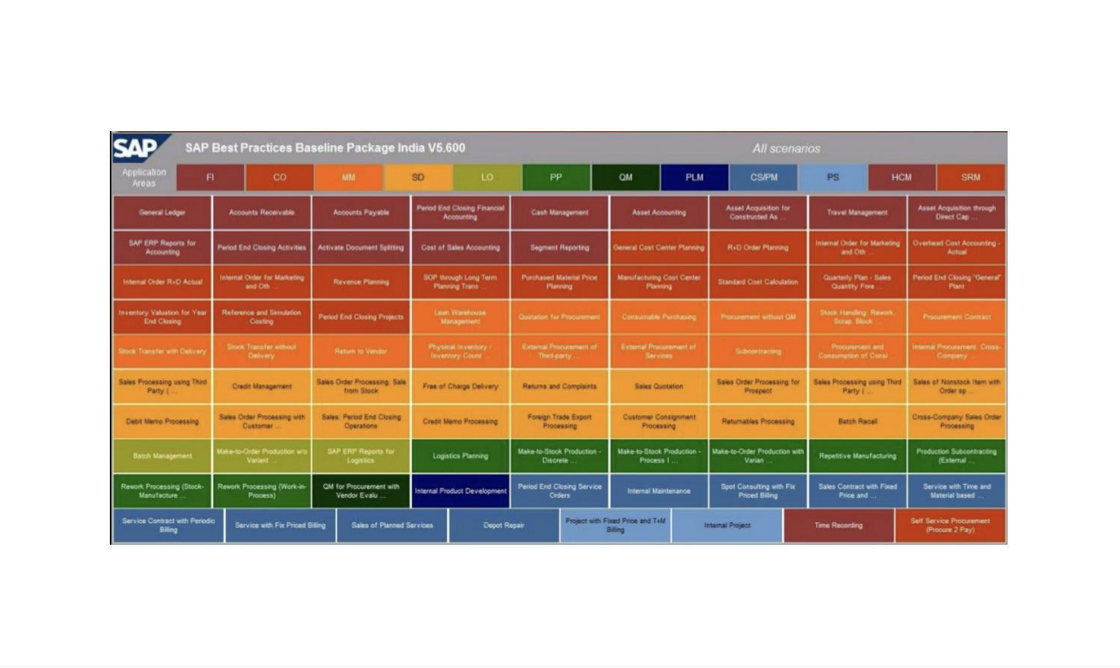
SAP är mästare på struktur och gevitvis har de även gjort en bra struktur på sitt system. Läs här hur du kan översätta SAP till Prime Archs arkitektur.
Två viktiga aspekter för att bedöma kvaliteten på ett definierat objekt i verksamhetsarkitekturen är namn och beskrivning. Läs mer om kriterierna här.
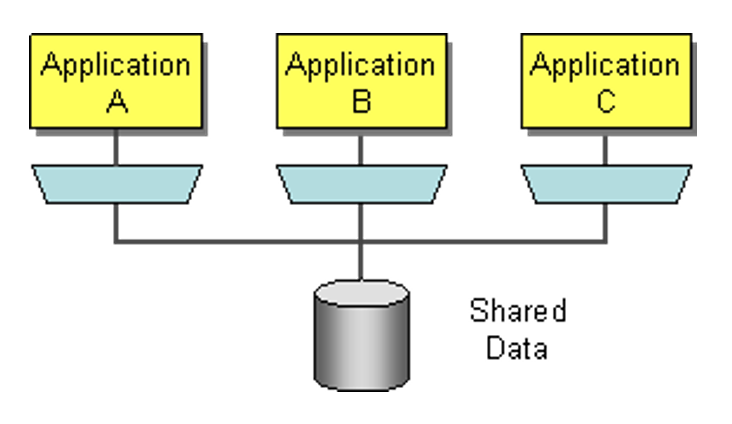
I introduktionsartikeln presenterades API-fokuserad integration, och i föregående artikel gick vi igenom transformationsmodulen, där data från ett System-API omvandlas enligt en kanonisk datamodell.
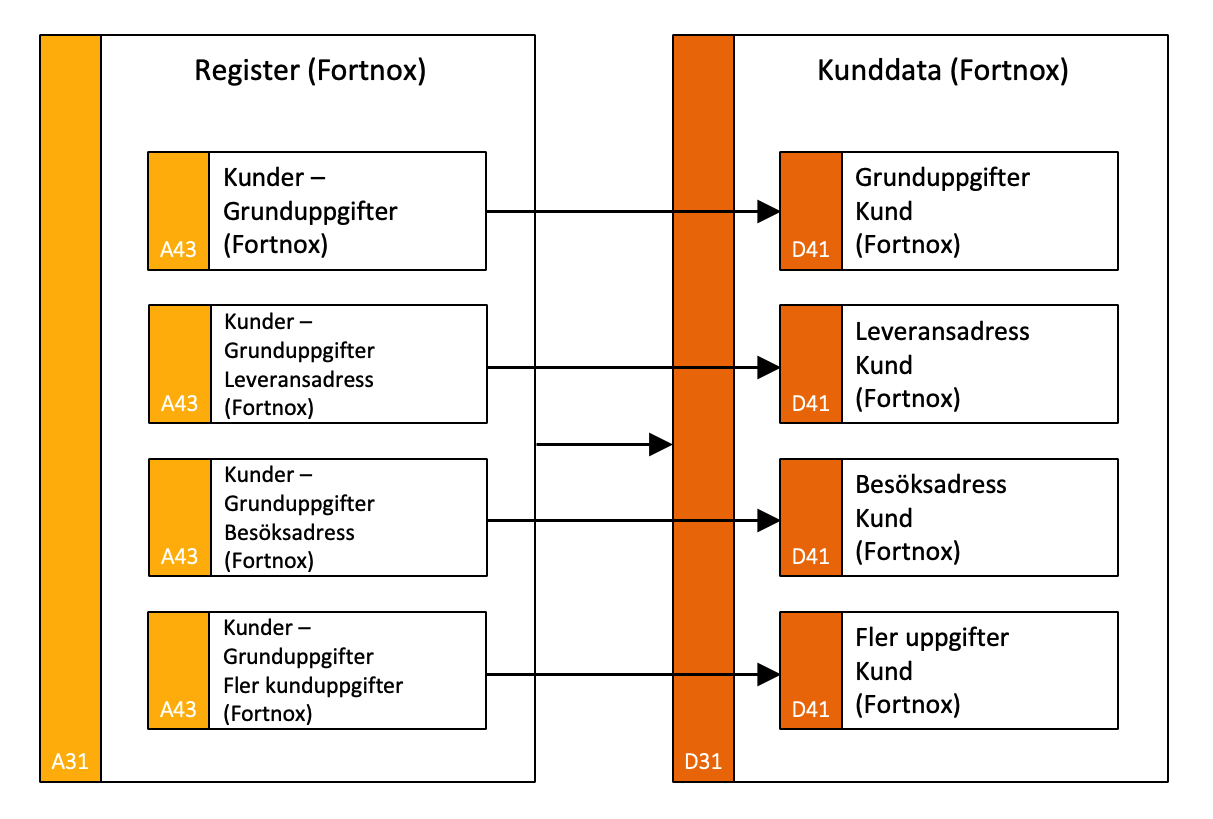
Skärmbilder (A43) används för att skrapa av data från befintliga applikationer (se artikel om Dataskrapning), men skärmbilderna ger även värdefull information om vilket data som lämpligen skapas, uppdateras eller konsumeras tillsammans. Varje skärmbild innehåller en uppsättning datafält, i Prime Arch Datatermer (D52), och dessa bildar ett Dataobjekt (D41).
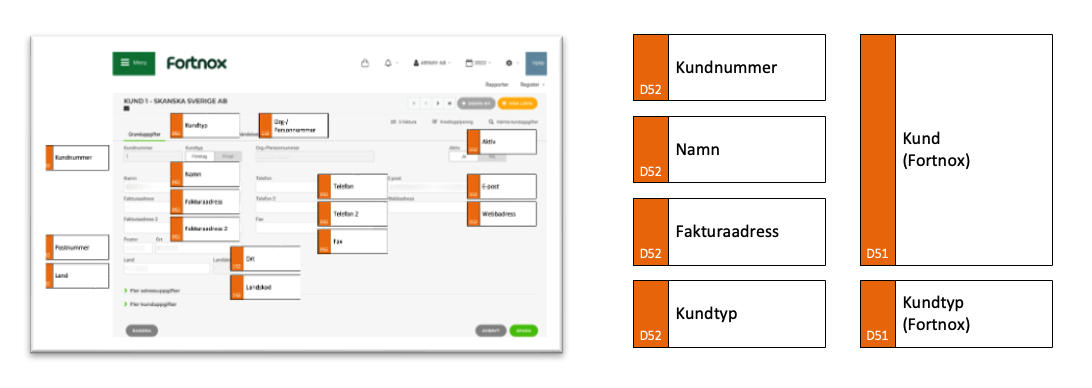
Dataskrapning är en metod som kan användas för att snabbt kartlägga befintliga datastrukturer, d v s hur verksamhetens information realiserats i olika applikationer.
I denna artikel diskuteras varför och hur EA borde användas som verktyg för informationsklassificering.
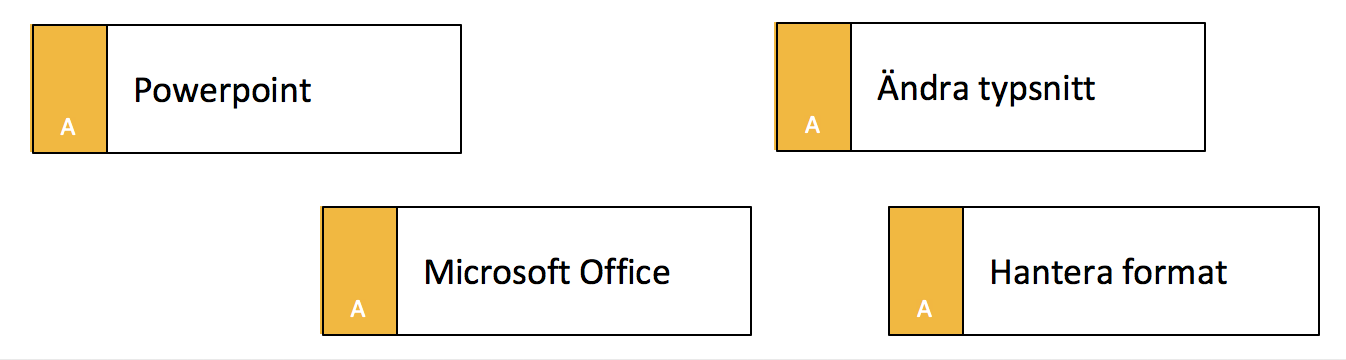
Funktionell nedbrytning beskriver de ingående delarna i en applikation men är inte en beskrivning av hur applikationen är implementerad rent tekniskt.
Känner du att det är trögt att få igång en processmodelleringsworkshop, att deltagarna är tveksamma att delta? Här är ett exempel som kan göra det enklare.
Ett framgångsrikt kravarbete kan sammanfattas i fem punkter: Sammanhang, Omfattning, Förankring, Prioritering och Definiering.
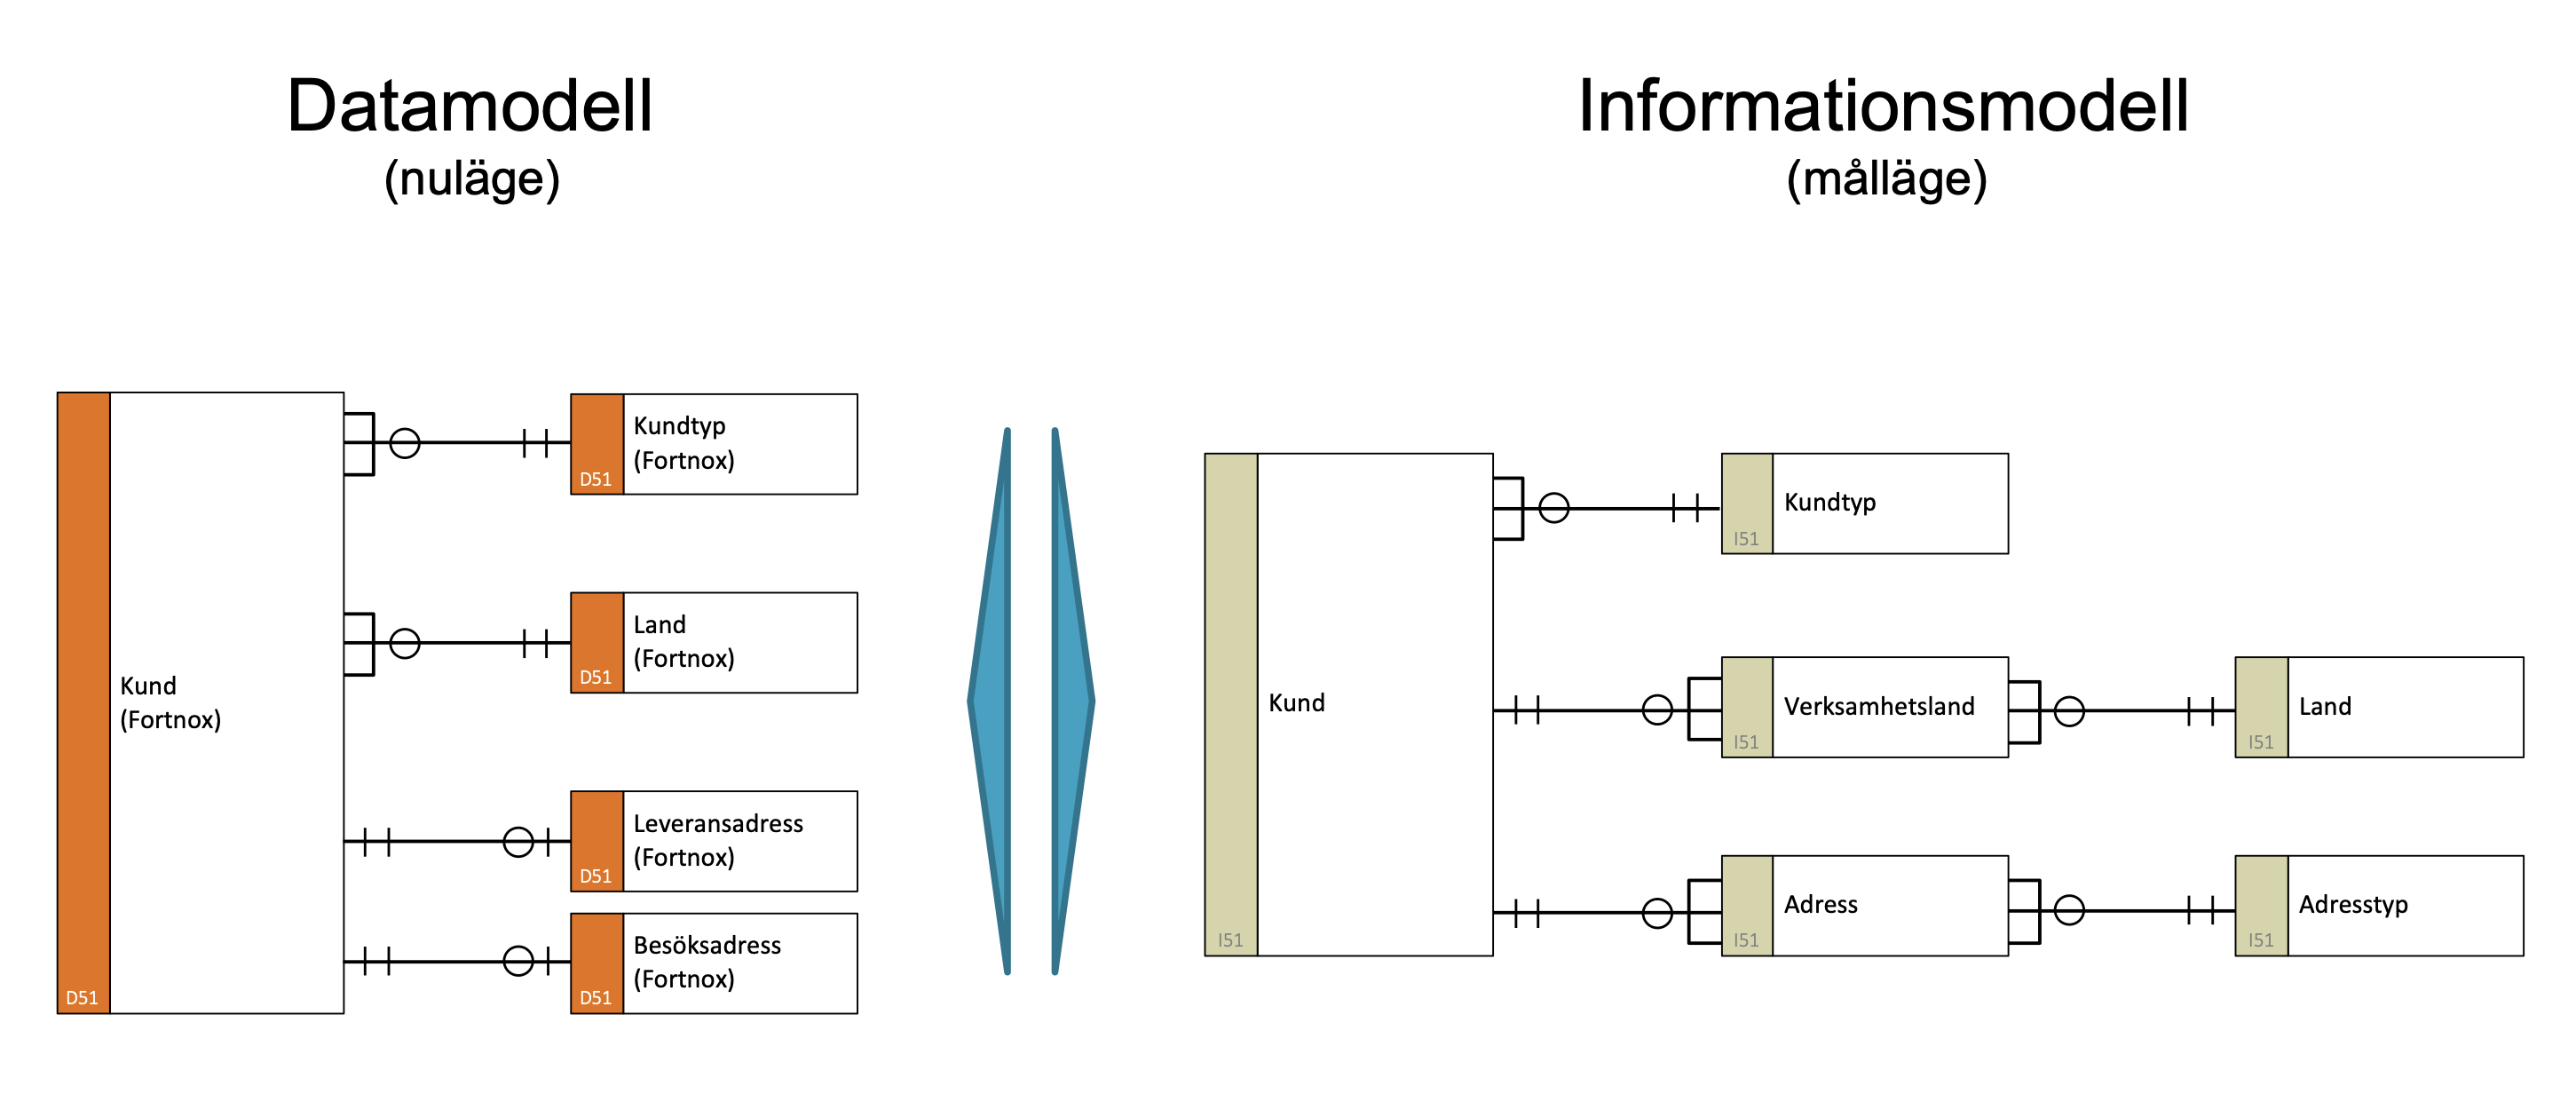
Att gå från datamodell till informationsmodell är ett naturligt nästa steg när vi vill lyfta blicken från teknisk representation till verksamhetskrav.
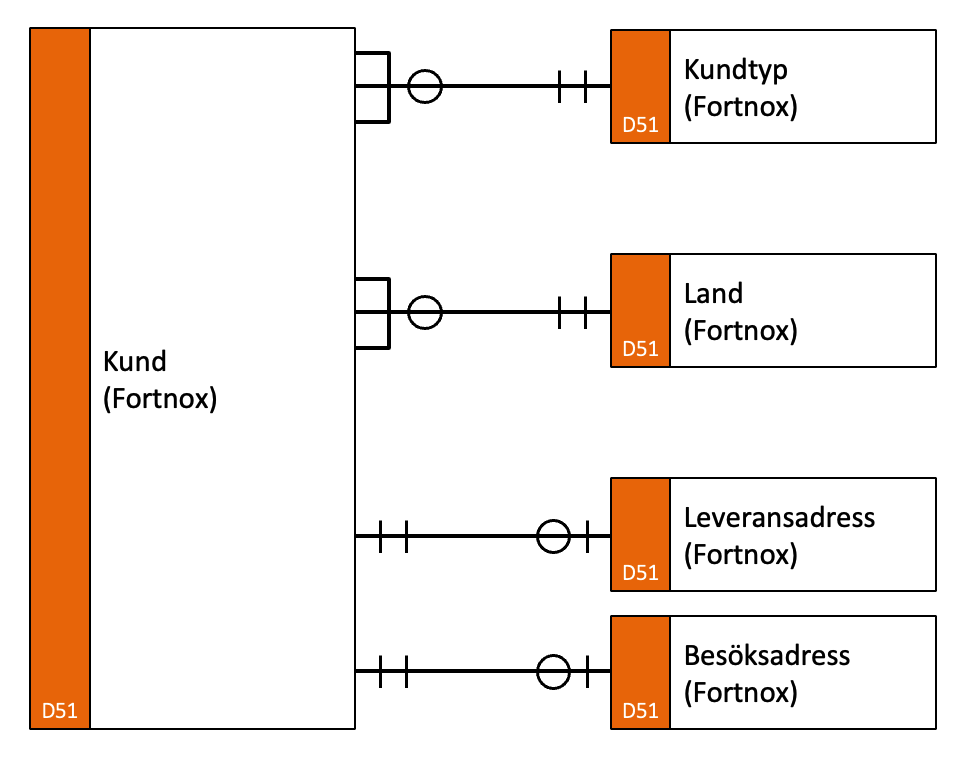
Datamodellen beskriver hur informationen realiserats i ett informationssystem. Den är således en beskrivning av hur datastrukturen faktiskt ser ut i nuläget, vilket nödvändigtvis inte är samma sak som hur informationen borde struktureras.
Informationsarkitektur handlar om att bringa ordning och struktur på verksamhetens information. Få en introduktion till informationsmodellering här.
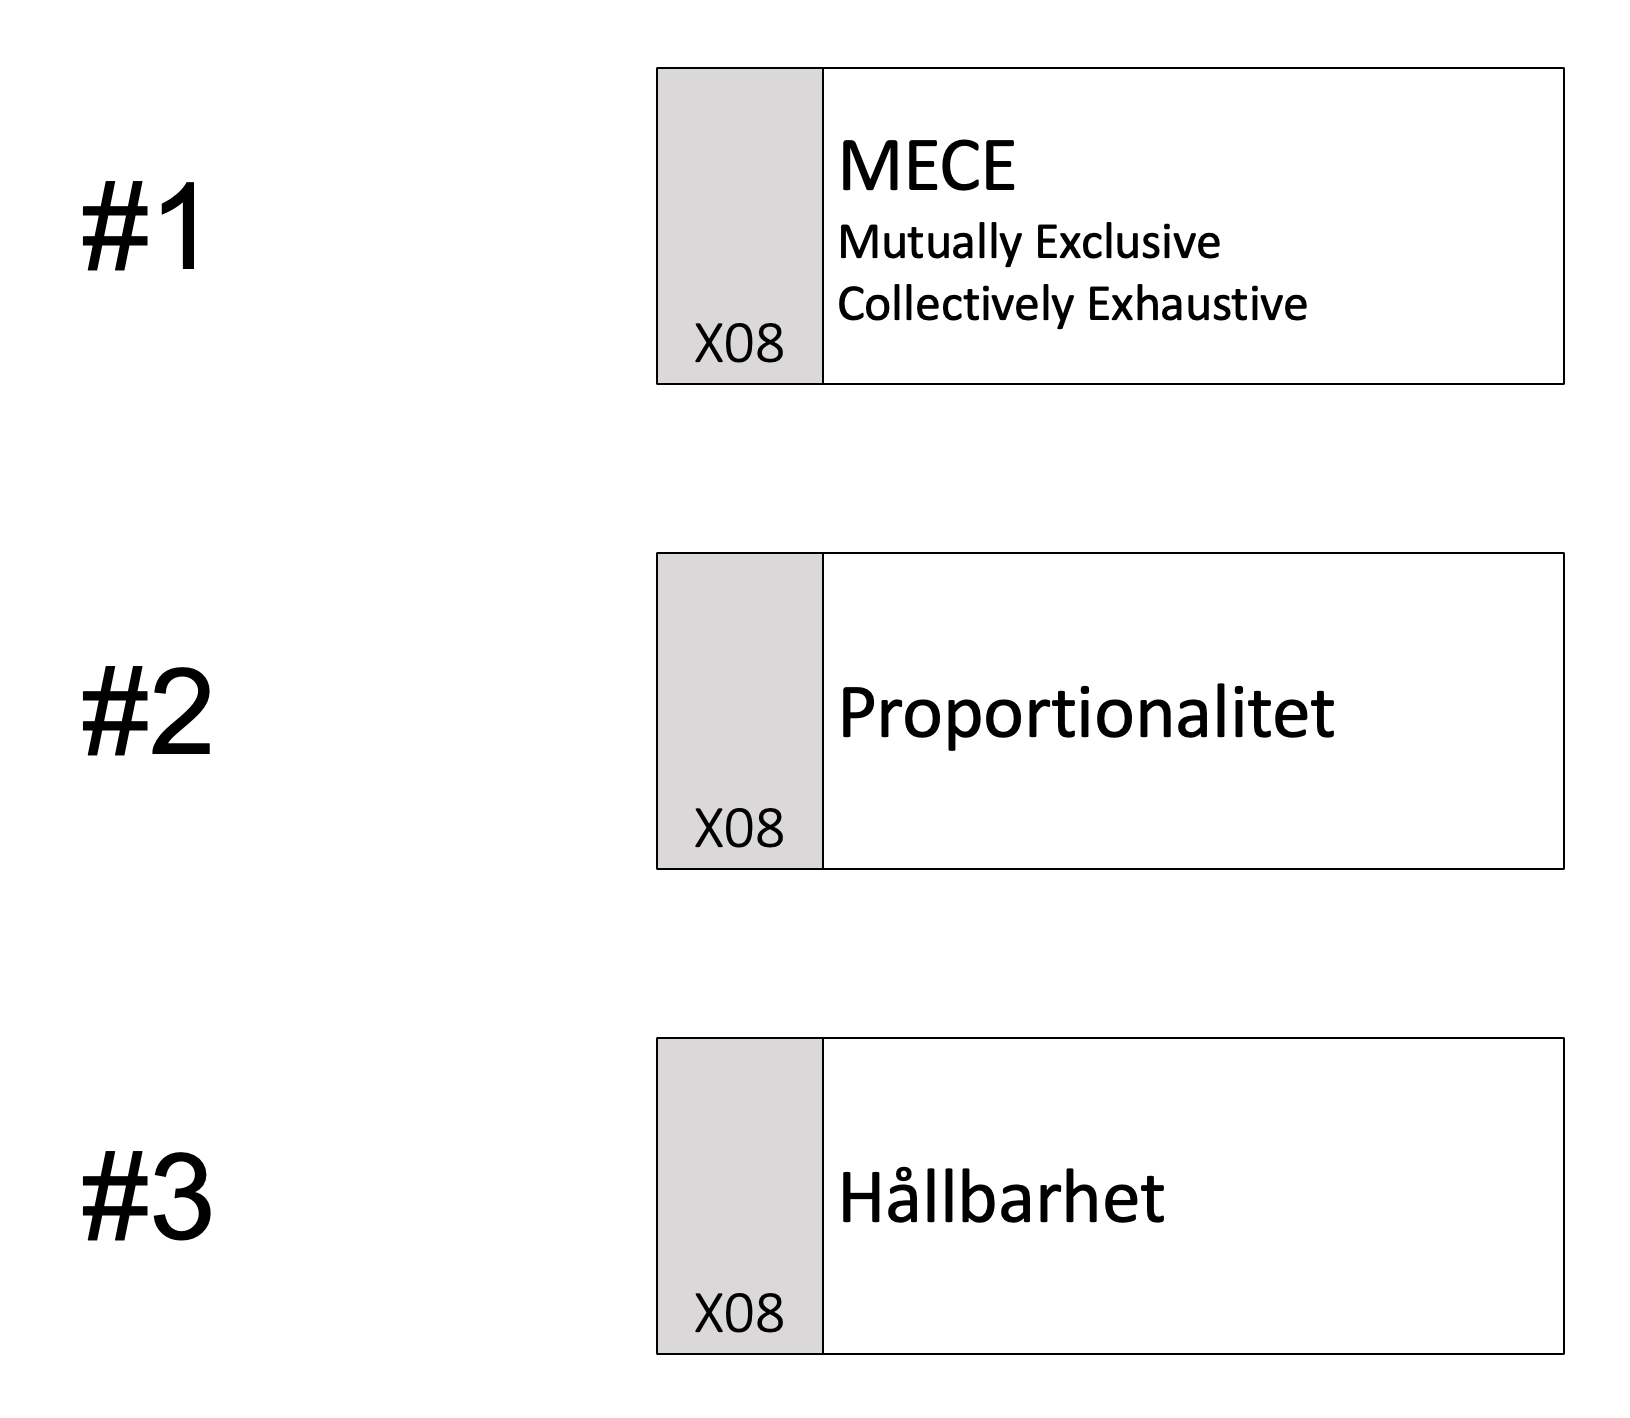
I förra artikeln gick vi igenom hur informationsarkitekturen är uppbyggd – från övergripande domäner till detaljerade entiteter. Men struktur i sig räcker inte. För att skapa en hållbar, begriplig och användbar informationsarkitektur krävs något mer: principer.
I artikeln "Grunderna i informationsarkitektur - på ett enkelt sätt!" används hemmet som en metafor för hur vi är vana att strukturera och organisera saker i vår vardag.
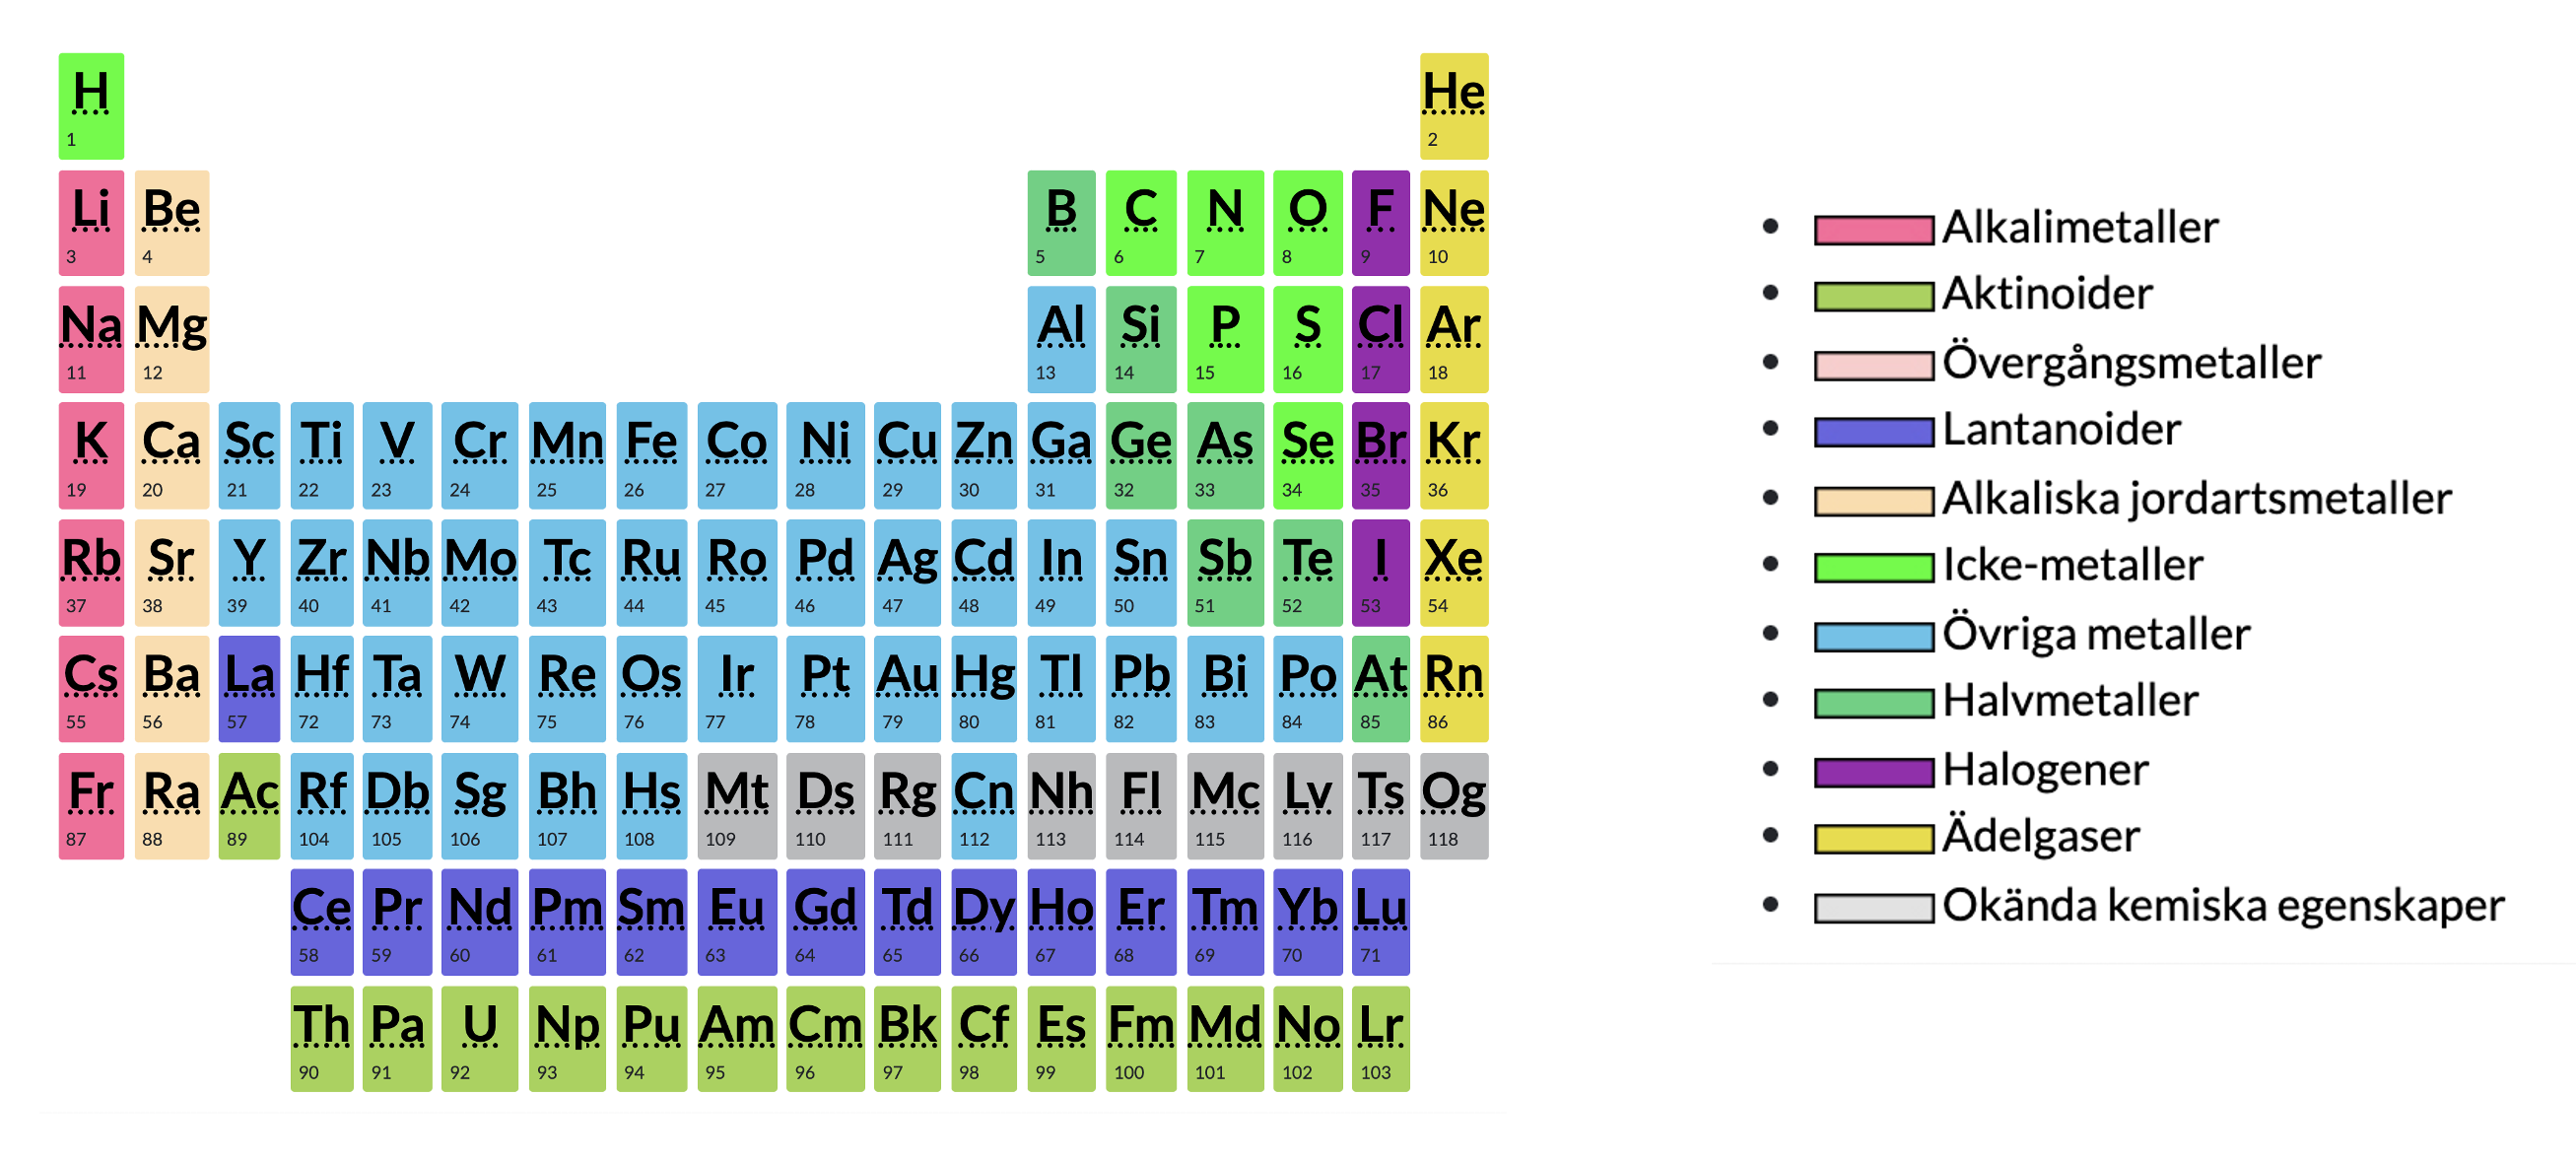
I föregående artikel, "Periodiska systemet som förebild, bekantade vi oss med det periodiska systemet som modell för struktur, systematik och framtidssäkring. Vi har sett hur varje grundämne har en given plats, tillhör en grupp, en period, och även ett kluster – eller ämnesklass.
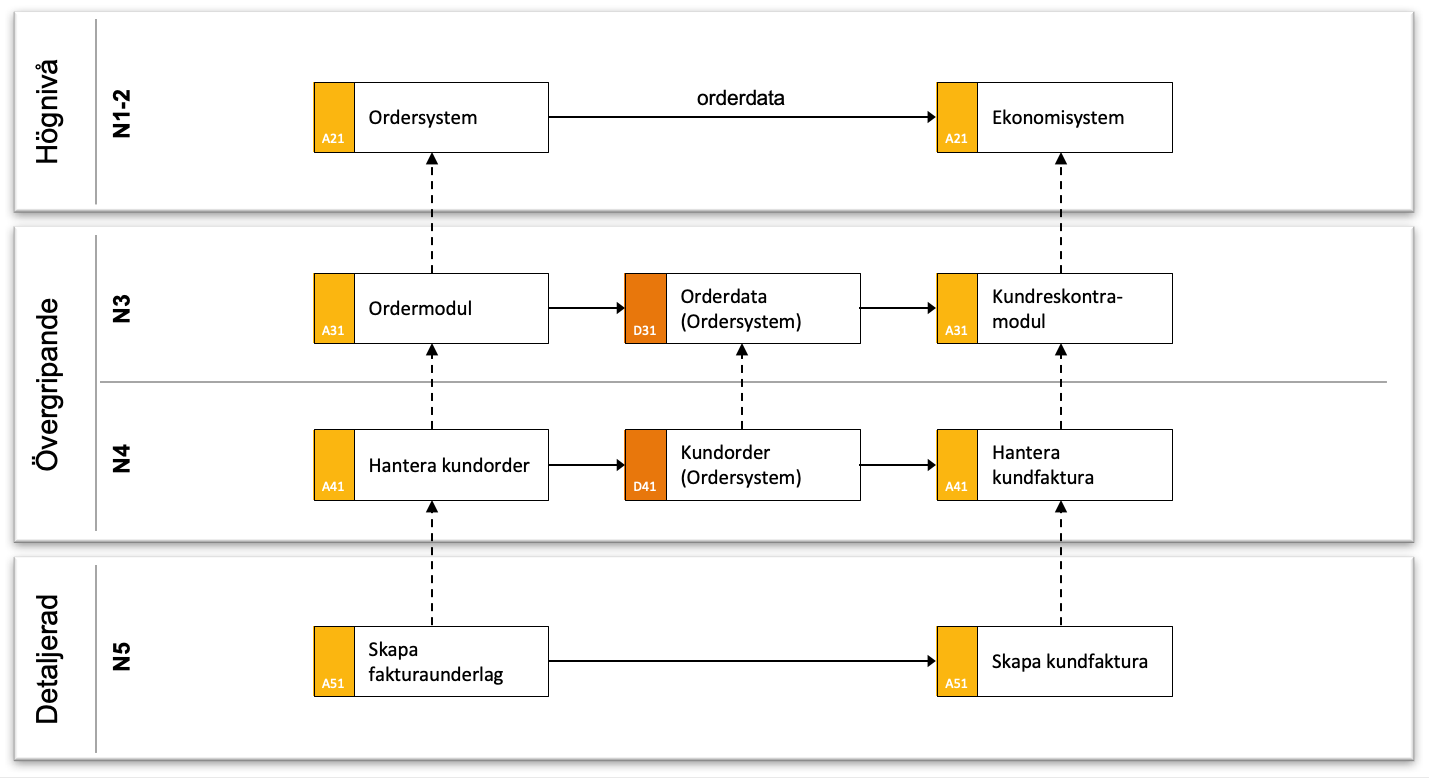
I Prime Arch Extended finns 5 nivåer för att beskriva applikationer och för integrationer. Här går vi igenom vilka de olika nivåerna är och deras syften.
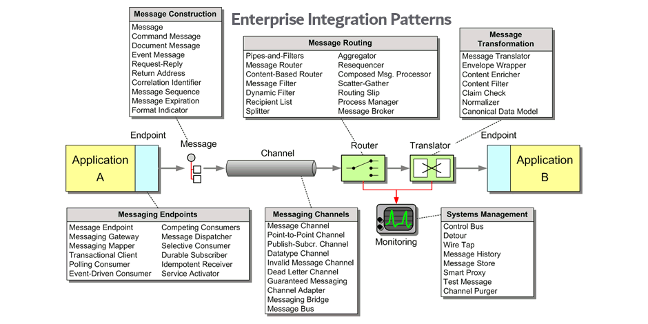
I föregående artikel beskrevs de olika API-lagren i en API-fokuserad integrationsplattform.
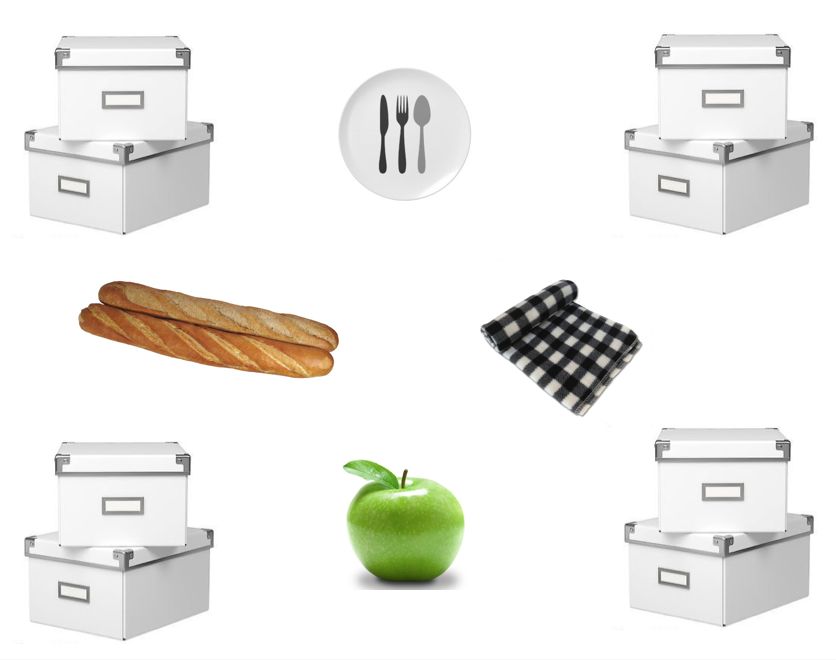
Att hålla reda på informationsentiteter, entitetsgrupper och informationsobjekt kan vara svårt. Här använder vi ett konkret exempel för att öka förståelsen.
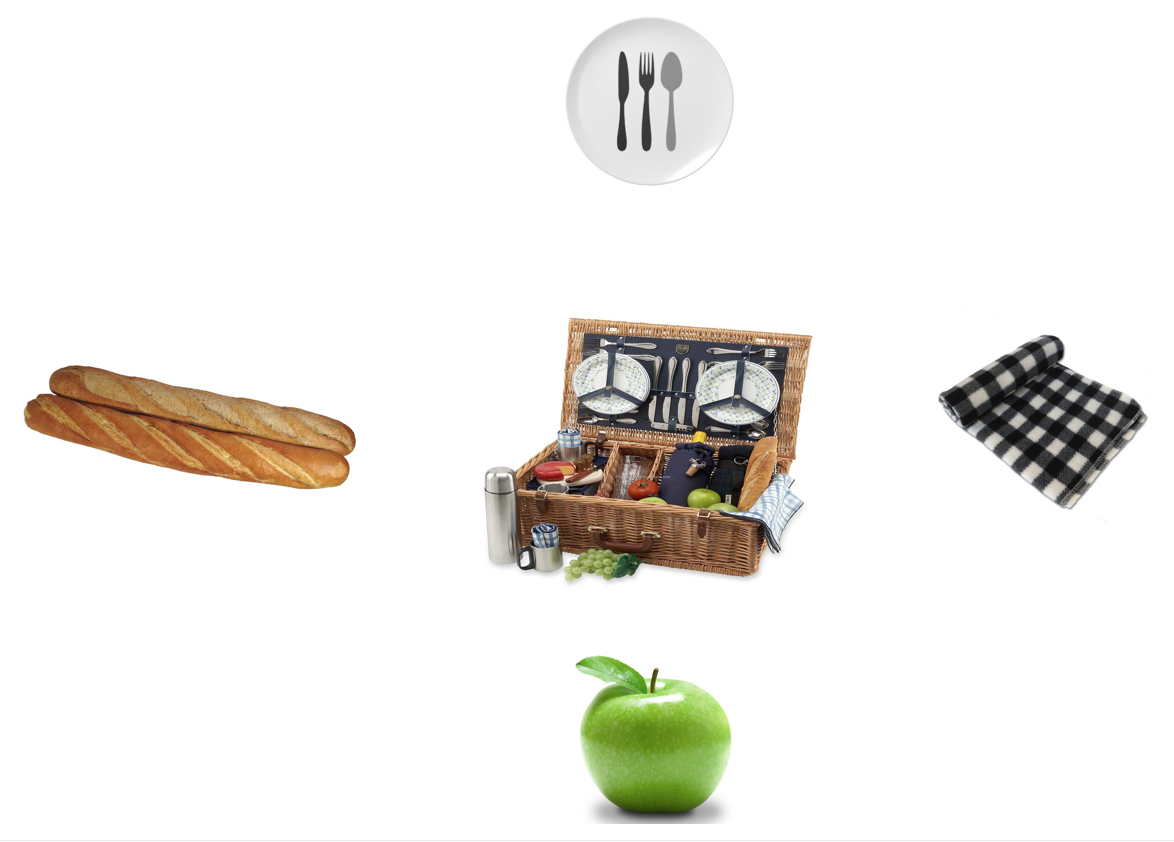
I den här artikeln fokuserar vi på informationsobjekten i arkitekturen. För att identifiera dessa behövs antingen ett processflöde eller ett förmågeflöde.
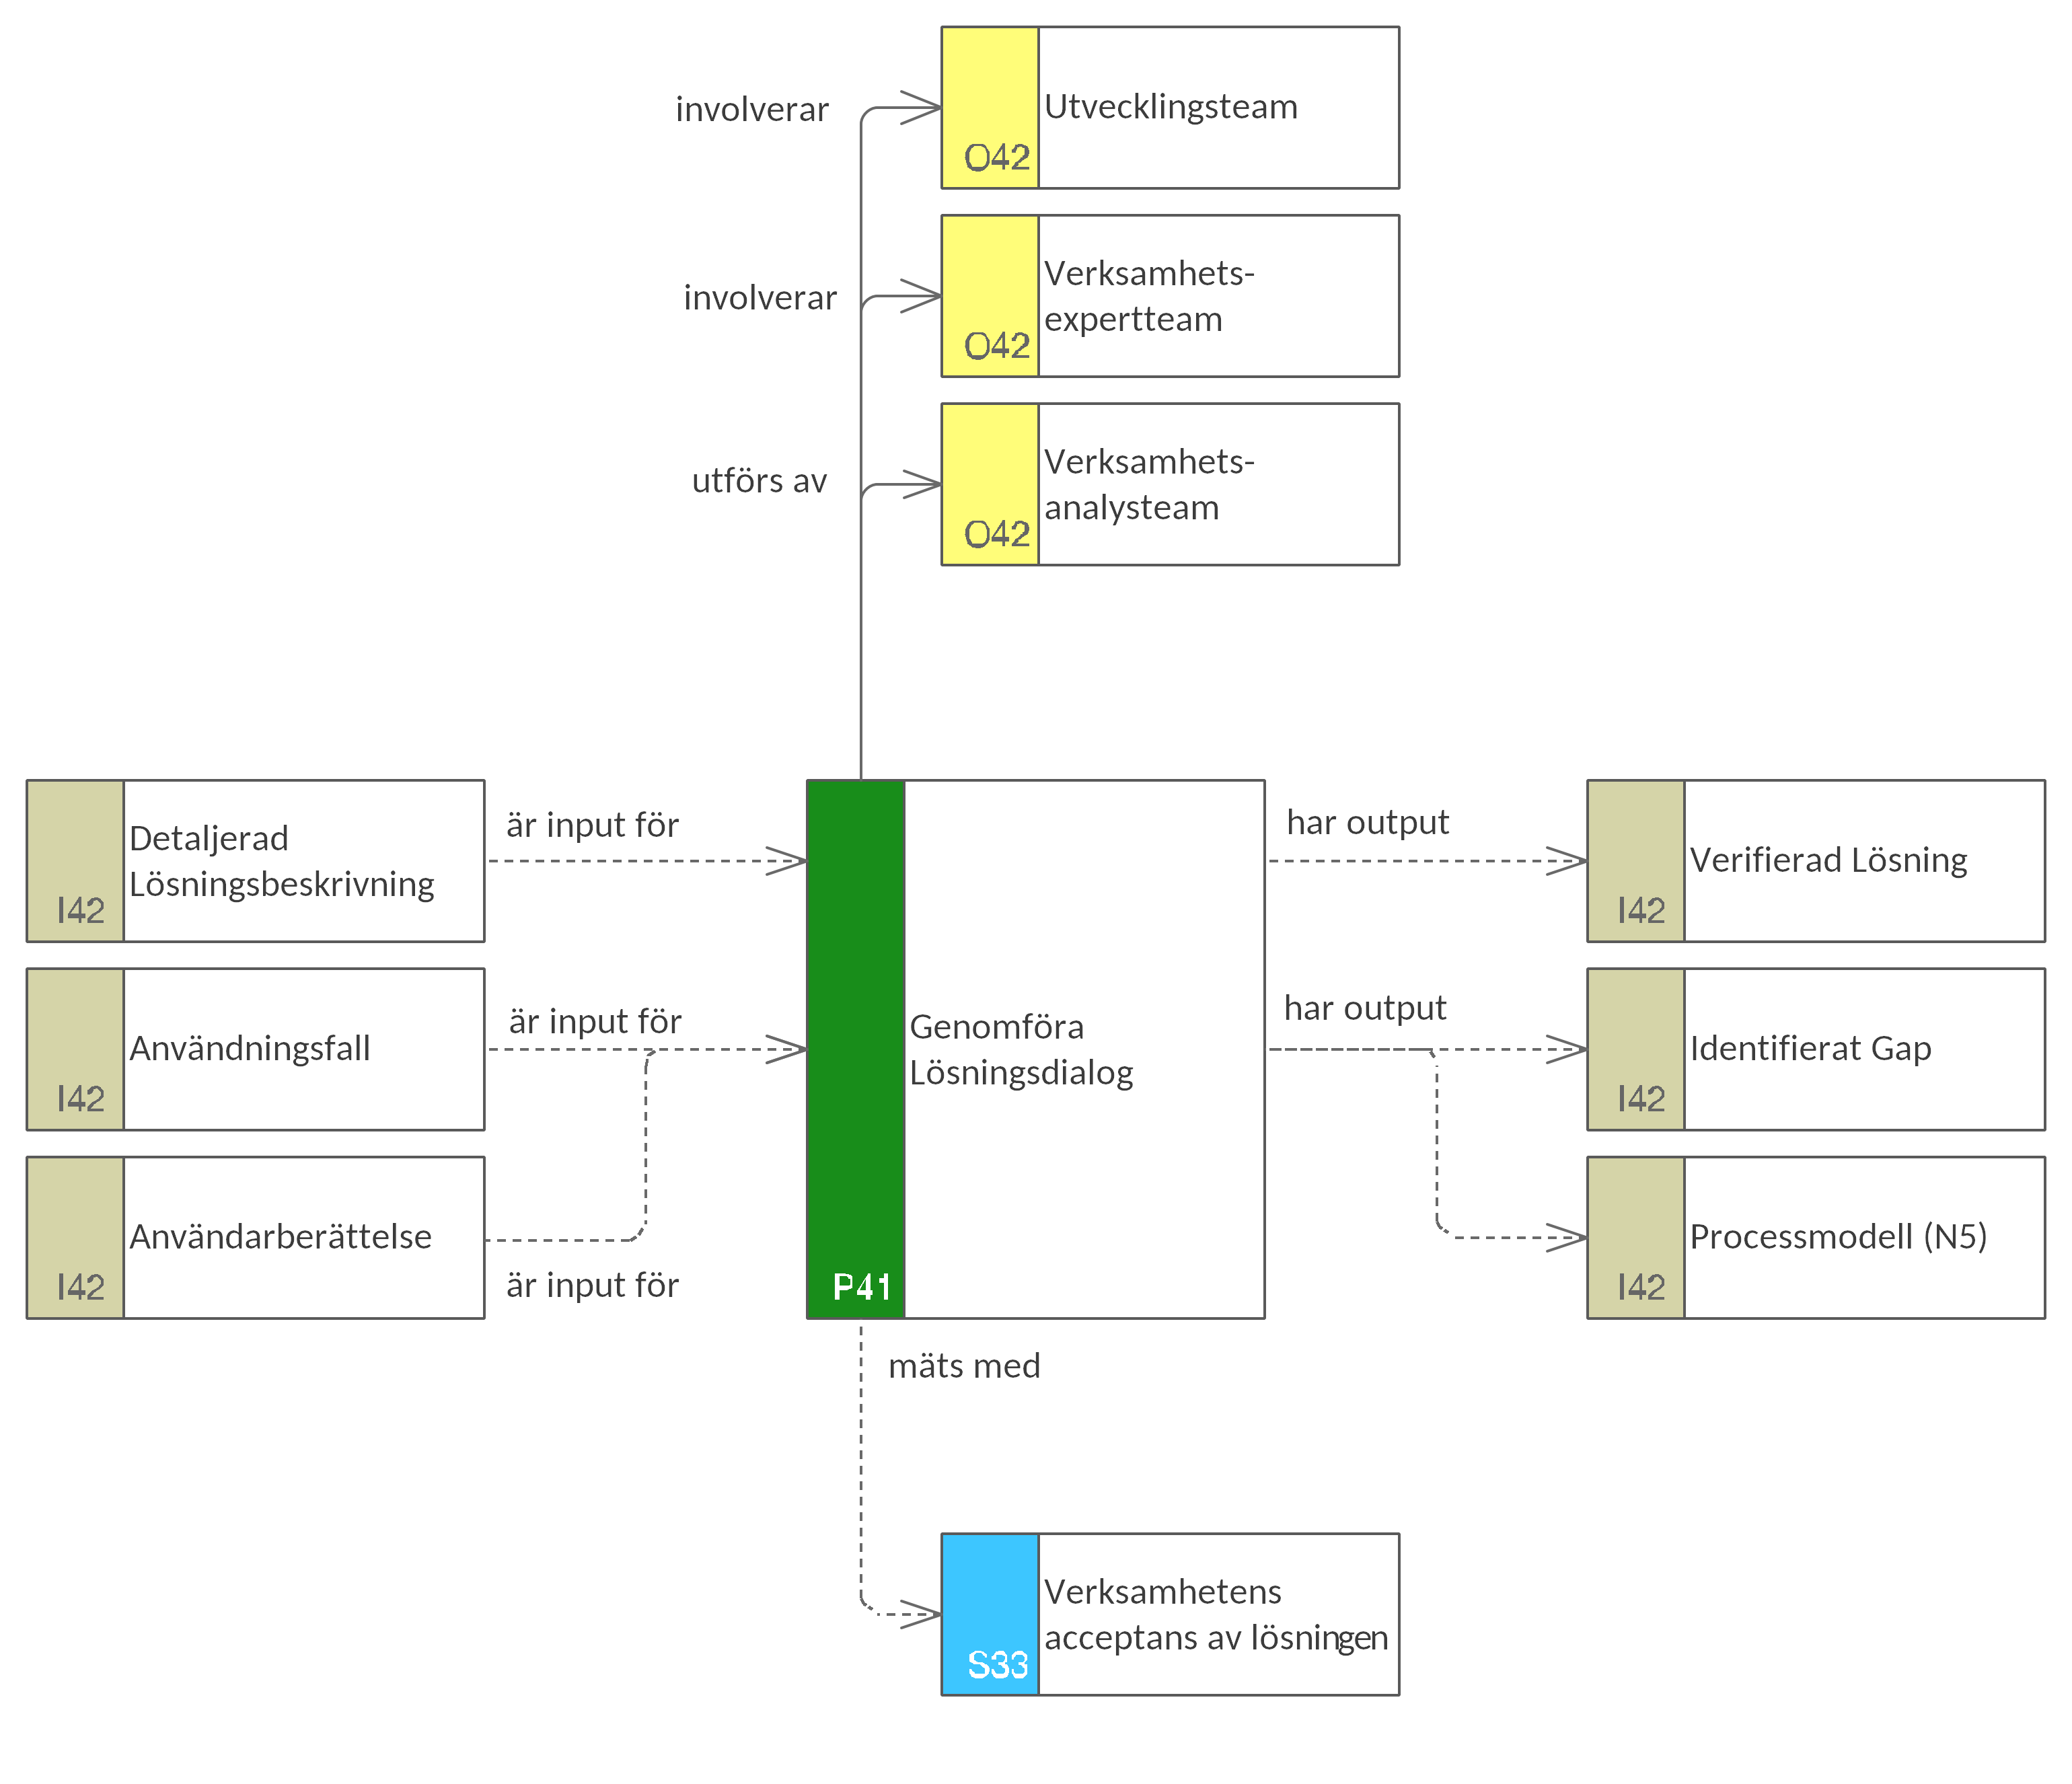
En lösningsdialog är en strukturerad dialog mellan en IT-leverantör och verksamhetens representanter. Läs om hur du nyttjar standardlösningen på bästa sätt
I artikeln "Exempel på applikationsnedbrytning" används Microsoft Office som exempel på applikation i vilken PowerPoint, Excel och Word ingår som applikationsmoduler.
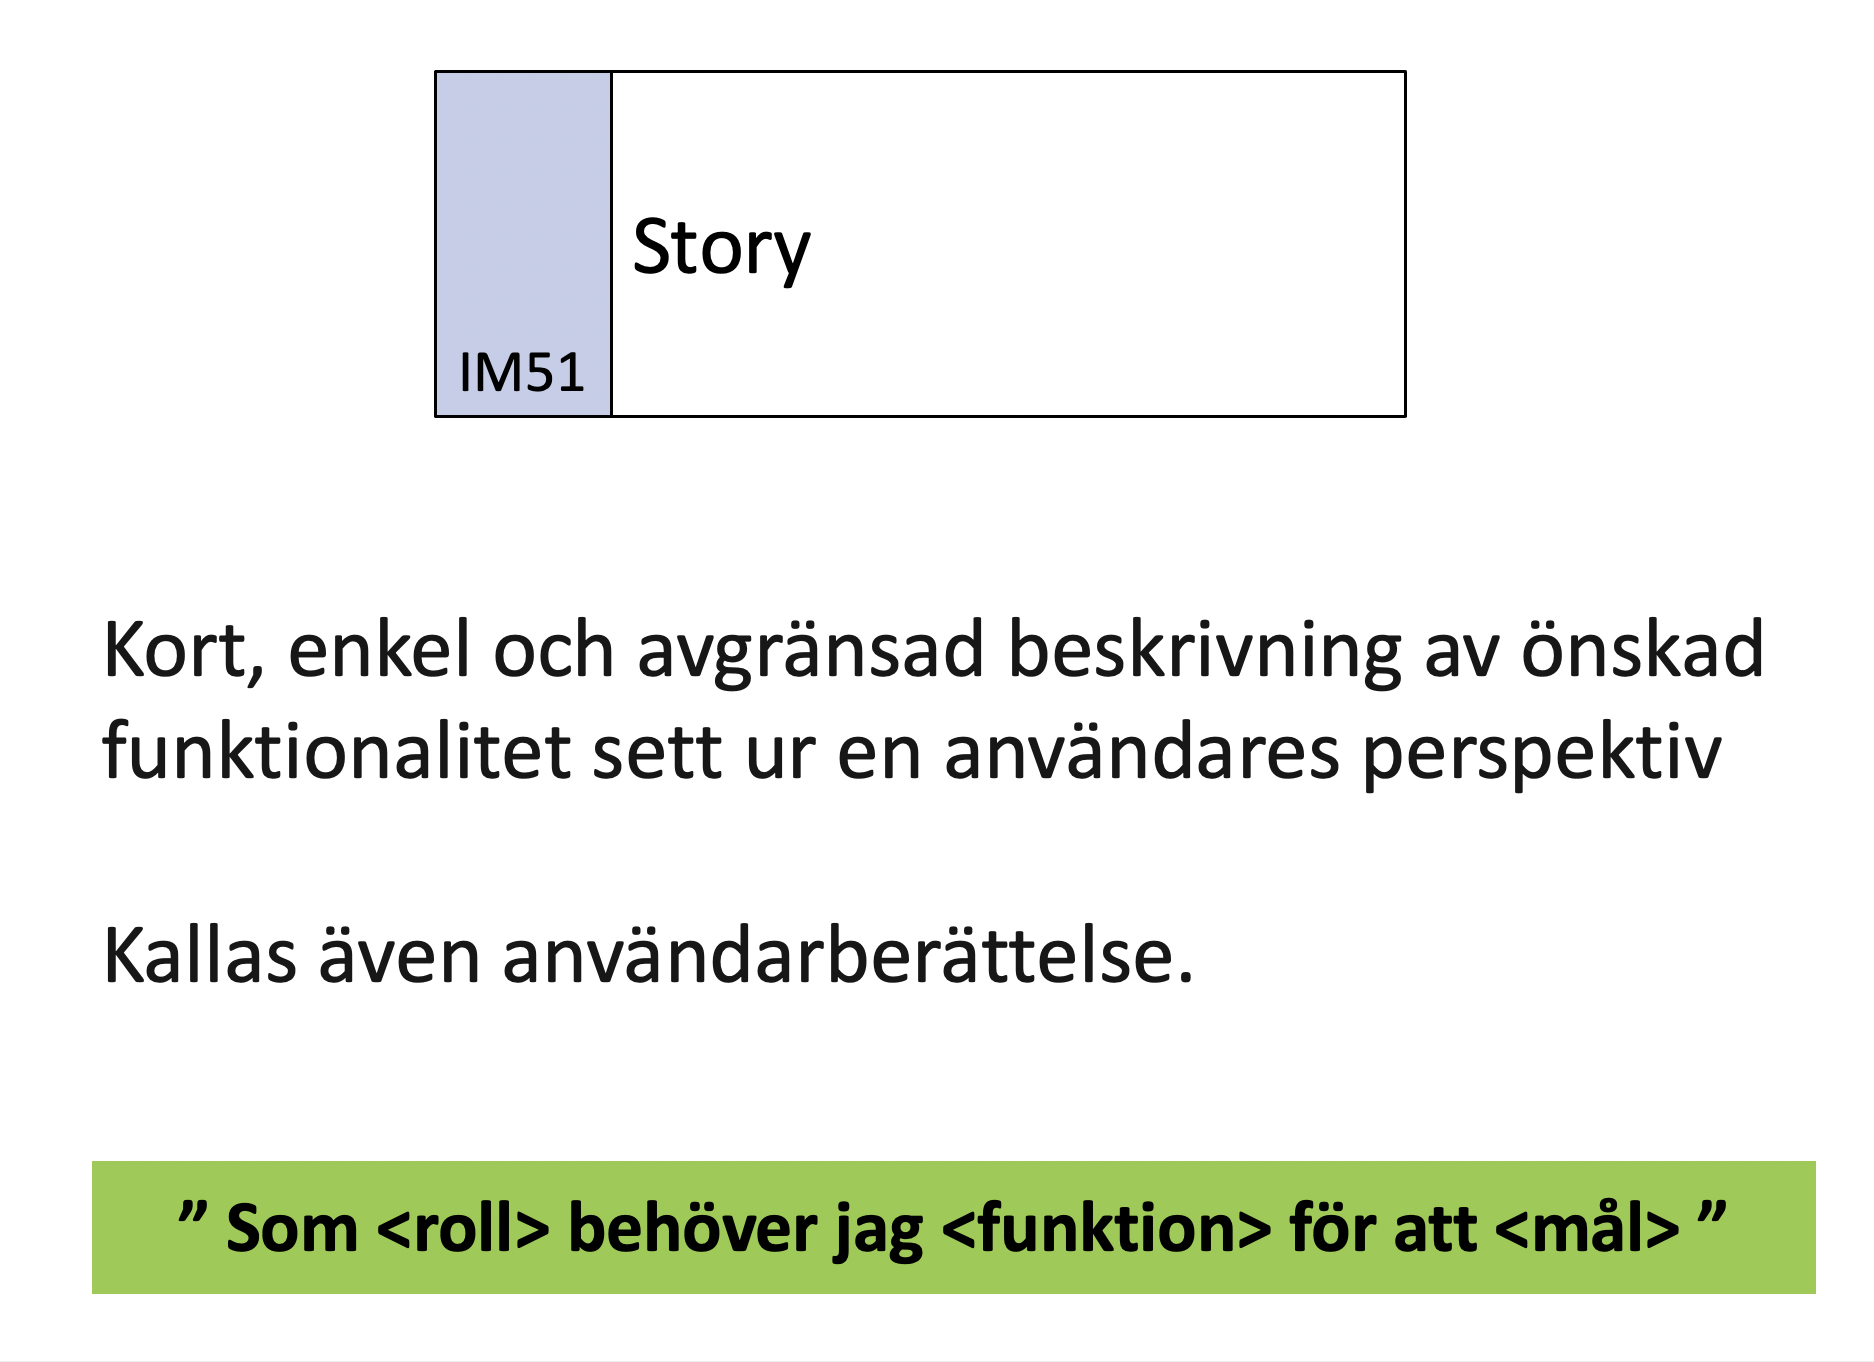
Användarberättelser är ett centralt koncept inom agil utveckling. Det utgår från användaren och vad denne behöver för att uppnå ett syfte/mål. Läs mer här.
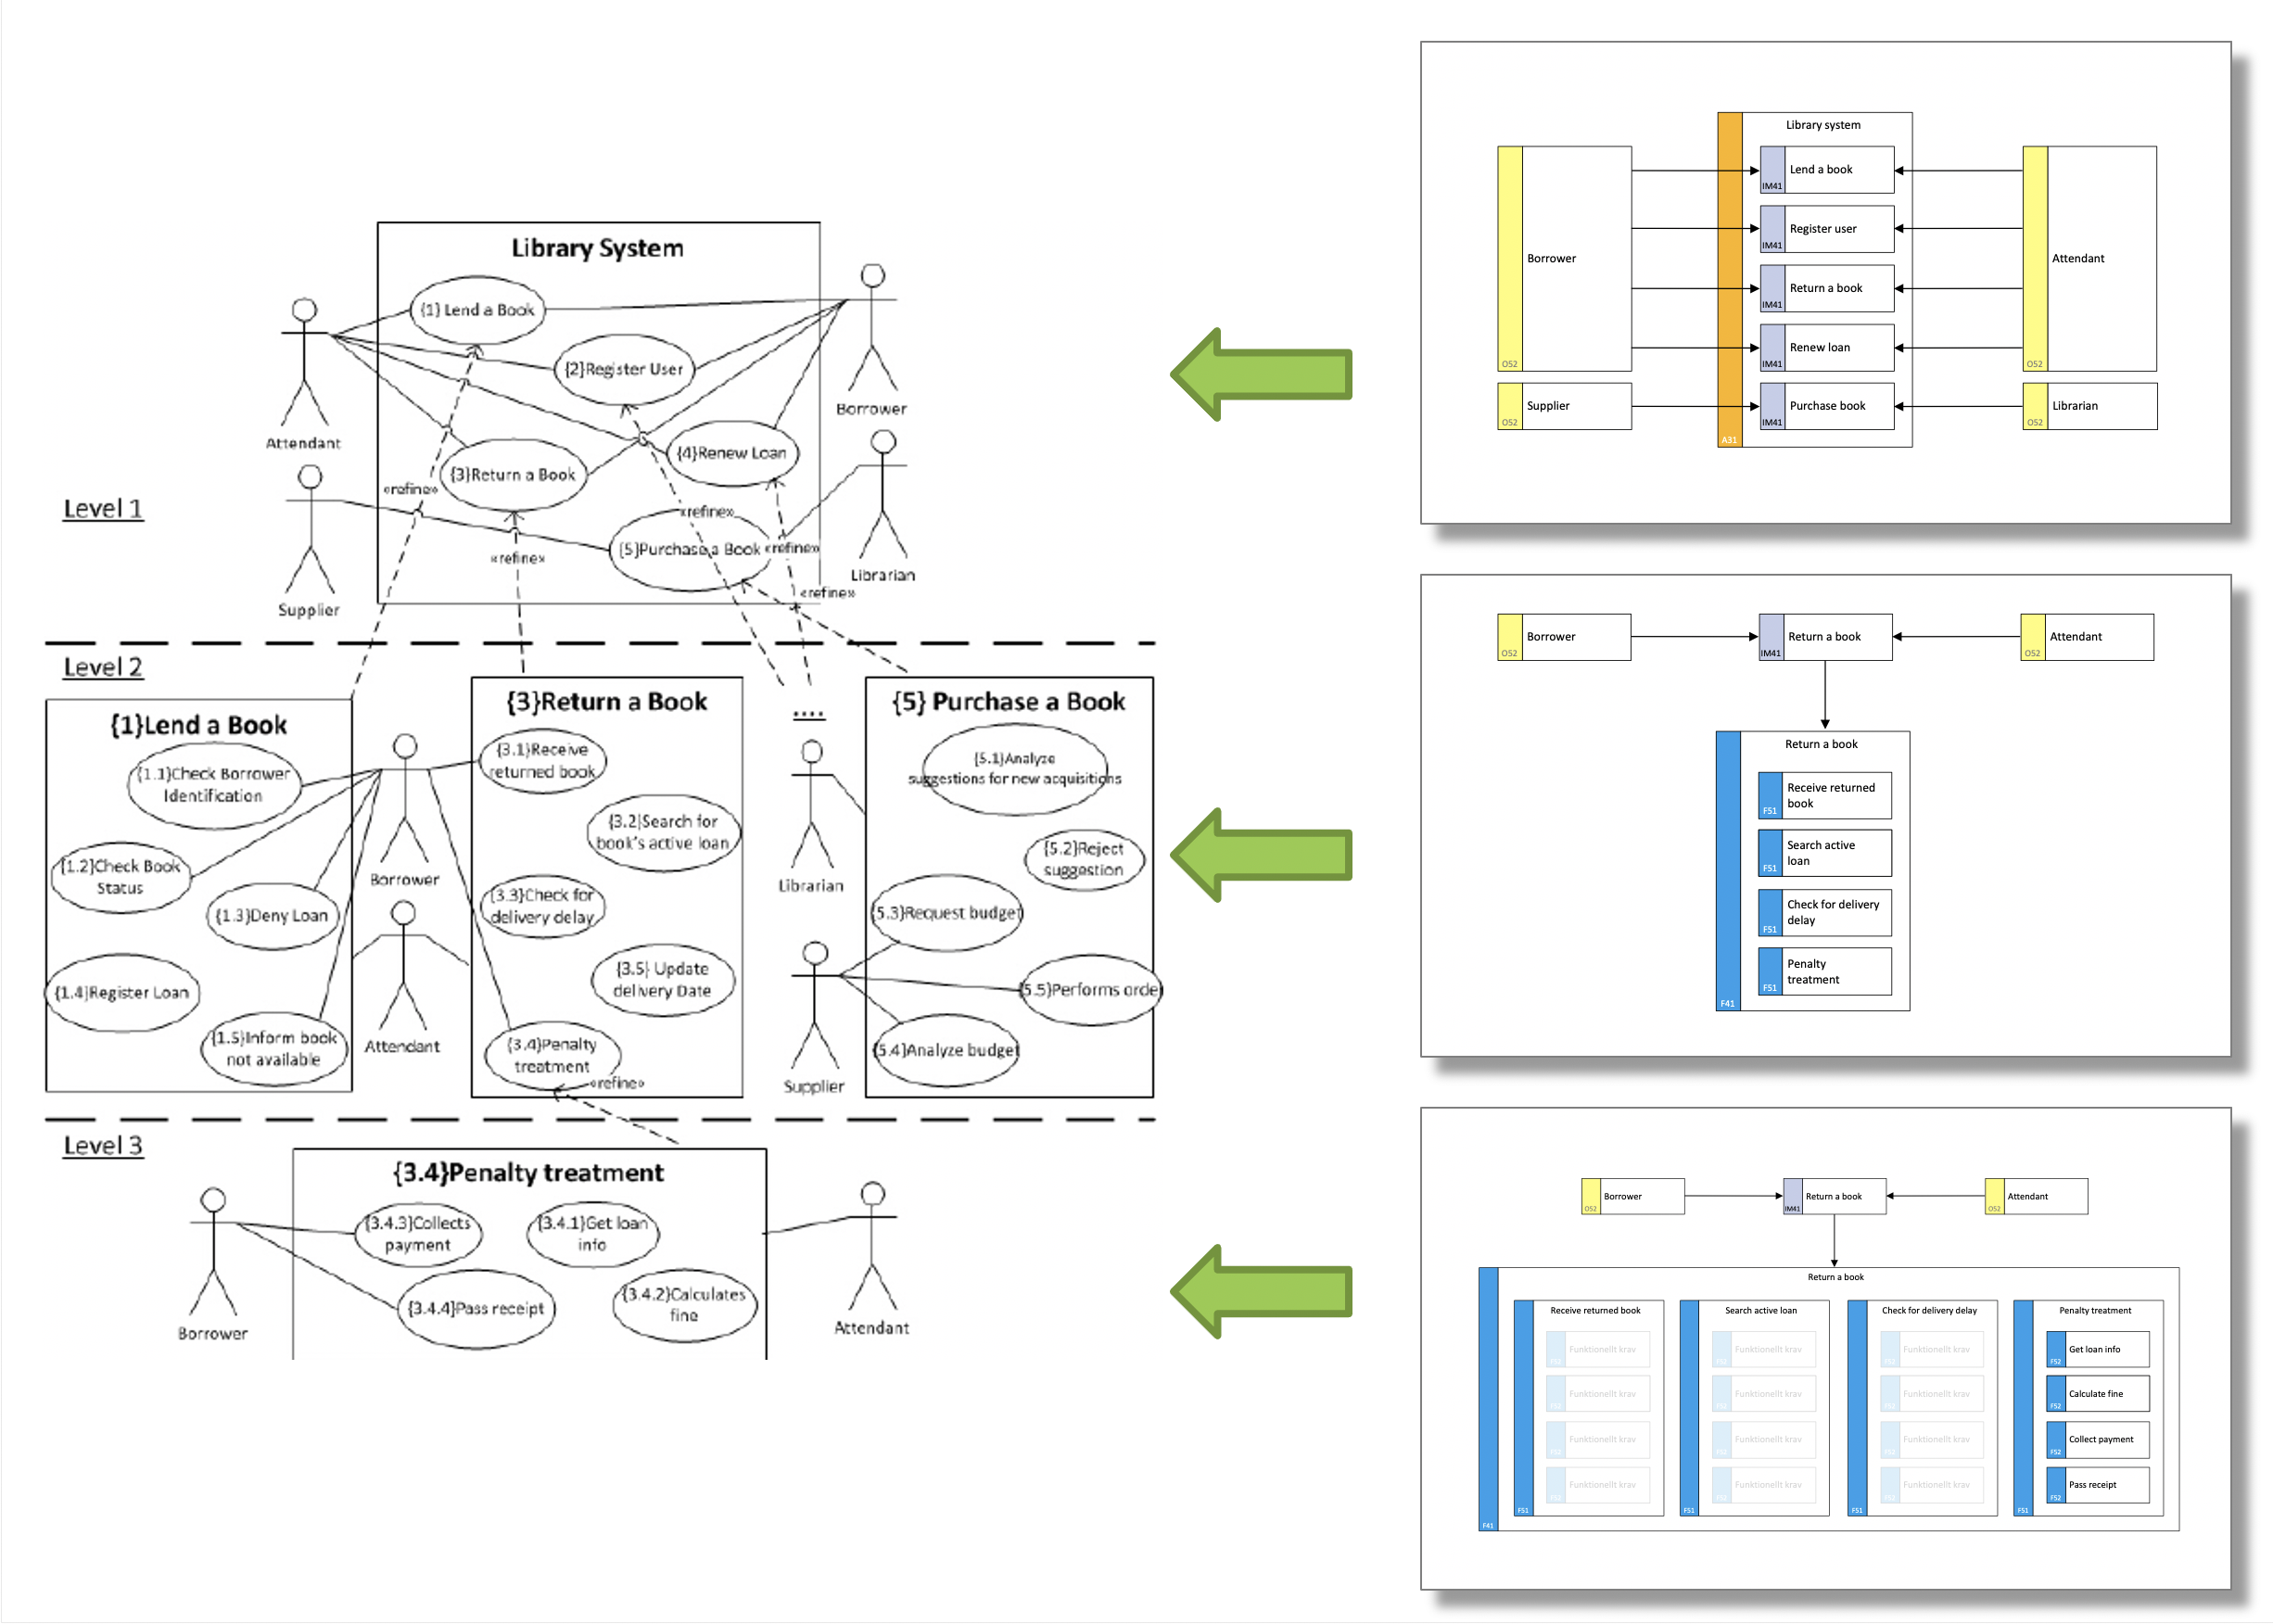
Användningsfall är ett vanligt verktyg för att identifiera funktionella krav som ställs på ett system. Läs mer om hur användningsfall/use case används här.
Vilka metaobjekt kan man använda för att modellera en Persona? Det finns tre kandidater att välja mellan Befattning, Person och Personroll. Läs mer här.
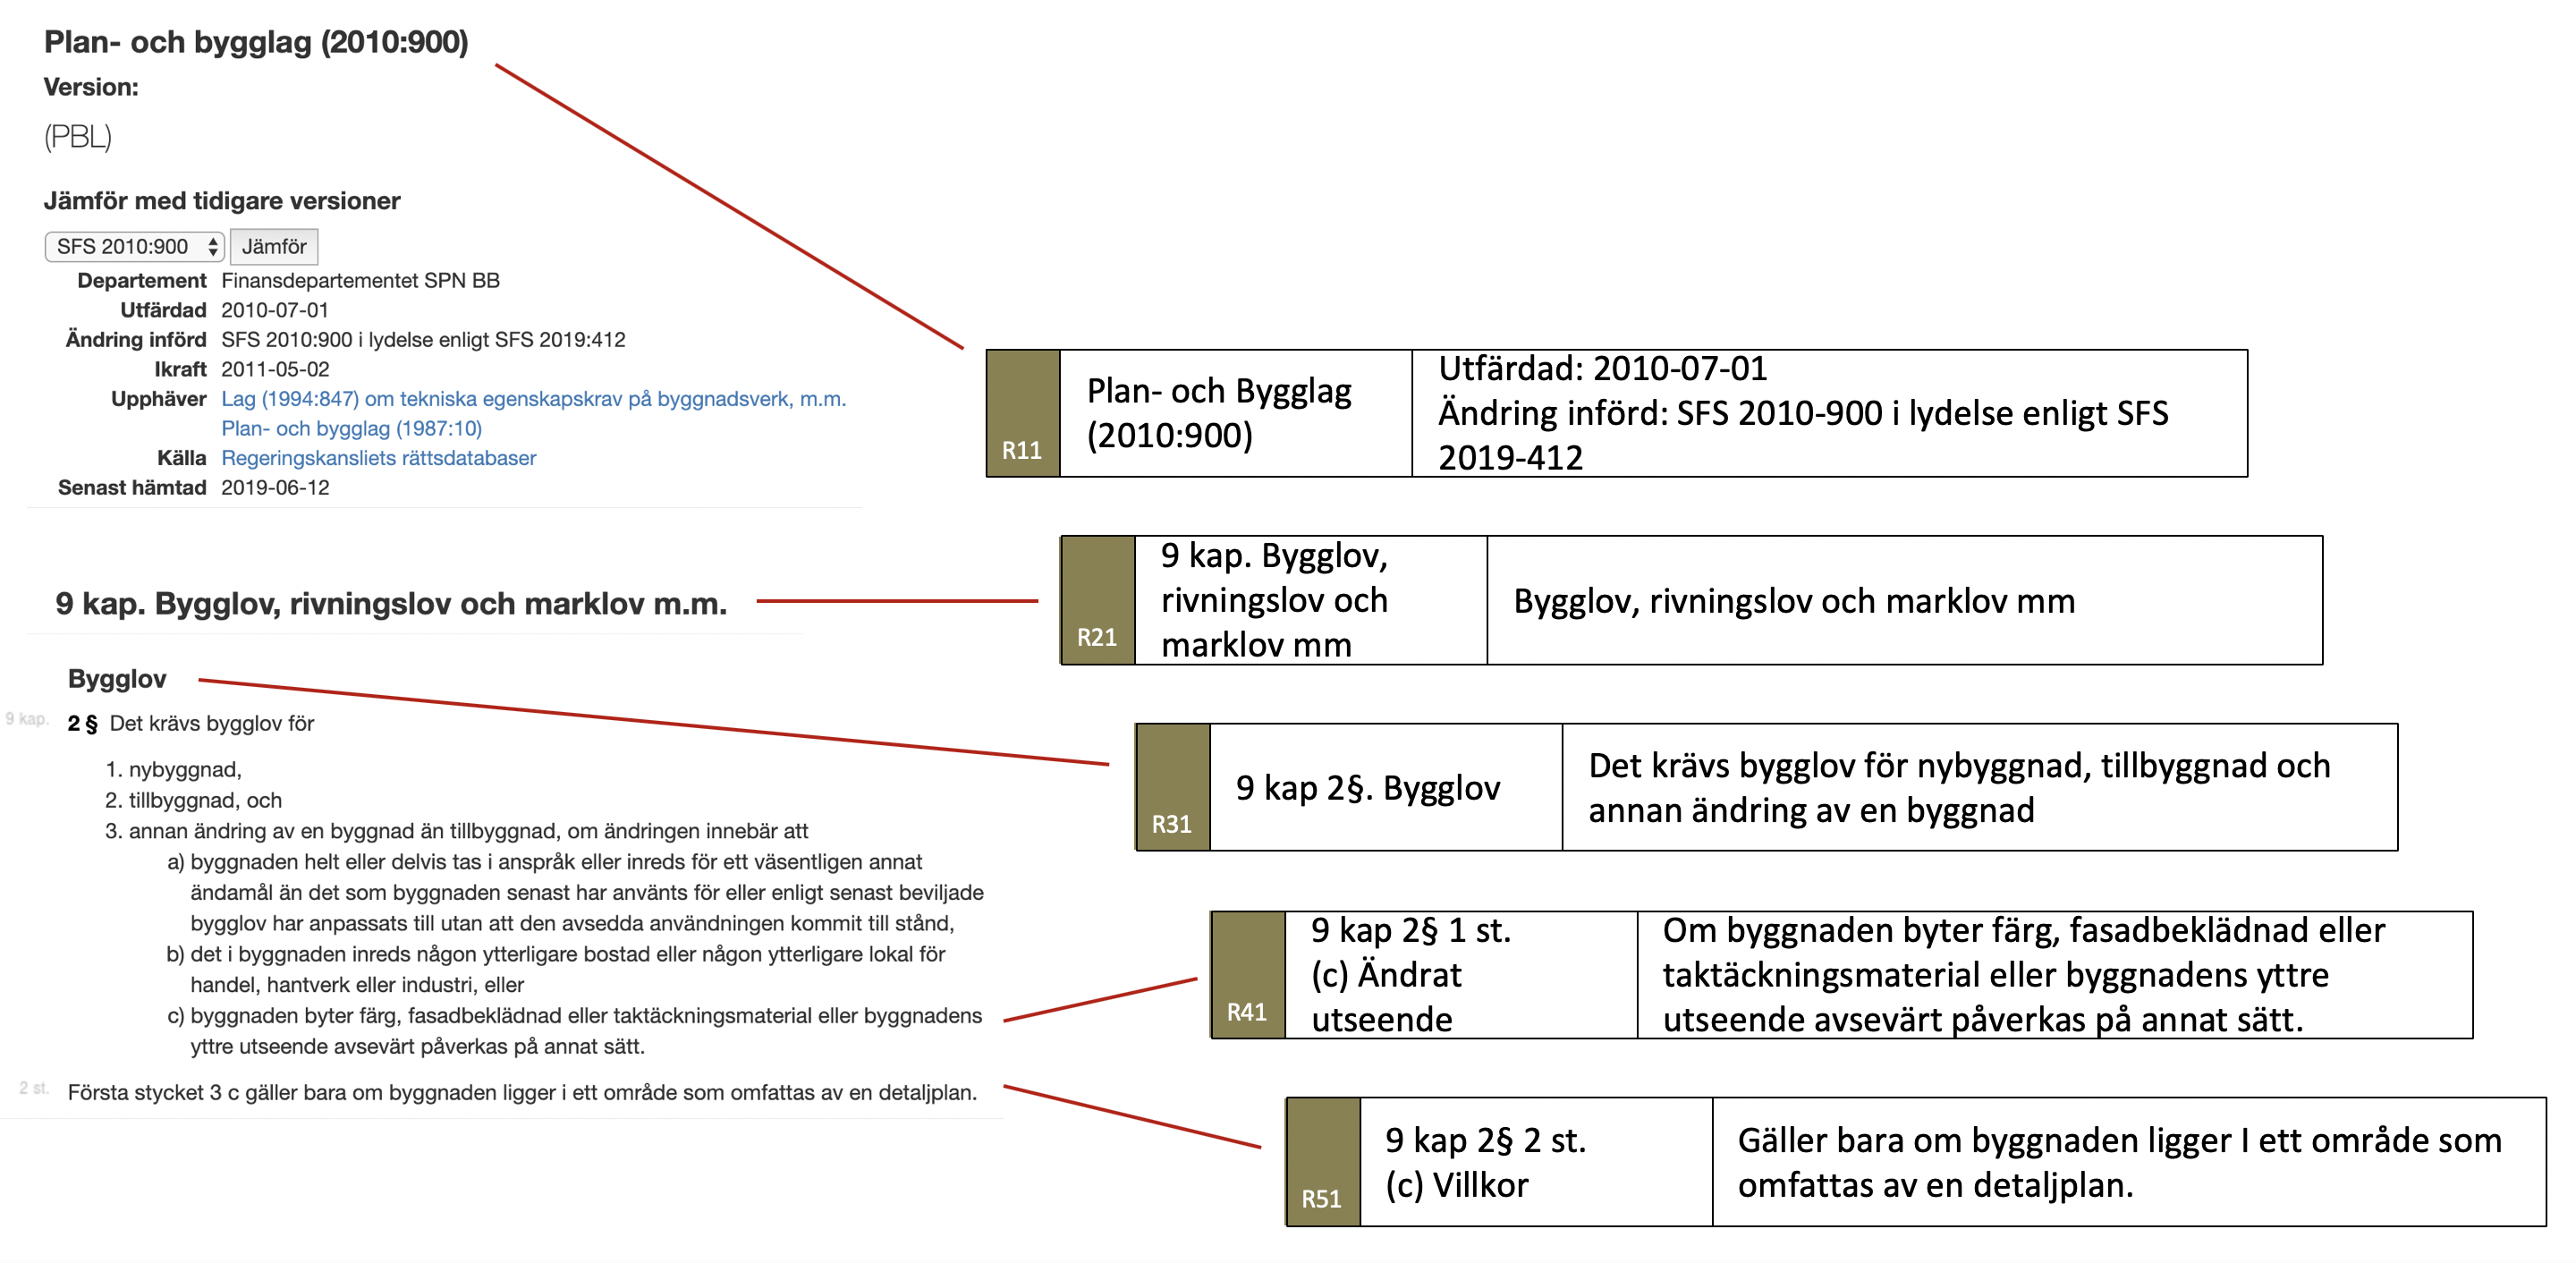
Det finns behov av att kunna beskriva strukturen i en lag för att kunna relatera till vilka delar som styr arbetssättet. Läs om modellering av lagtext här.
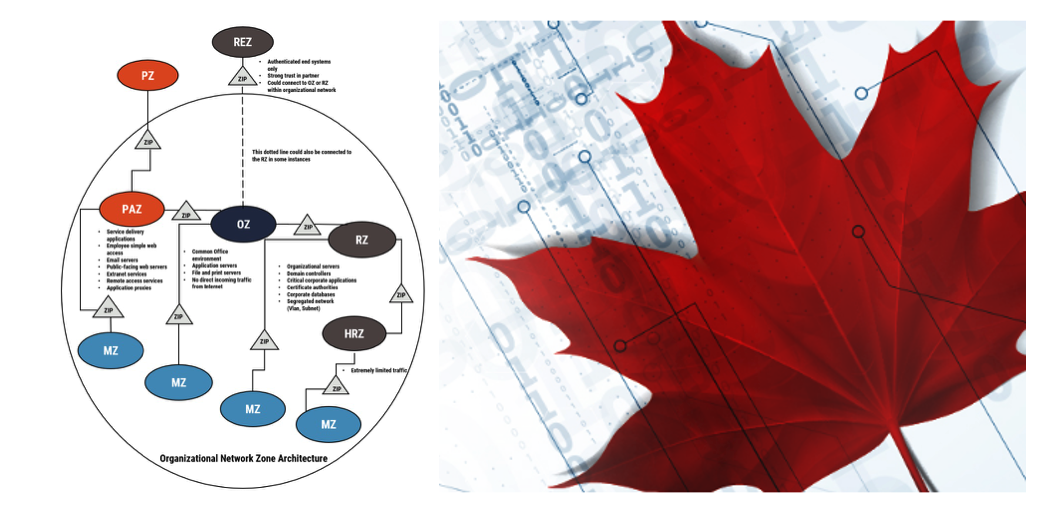
I artikeln Nätverksäkerhet med zonindelning visas hur nätverksarkitekturen deslas upp i olika zoner, baserat på exempel från Government of Canada.
Government of Canada förklarar i en artikel ("Baseline security requirements for network security zones") vikten av att använda nätverkssäkerhetszoner som en del av ett lagerbaserat säkerhetstänk. Artikeln beskriver även den funktionella modellen för dessa zoner, inklusive principerna och designfilosofin som styr användningen av olika säkerhetszoner för att separera IT-infrastrukturen.
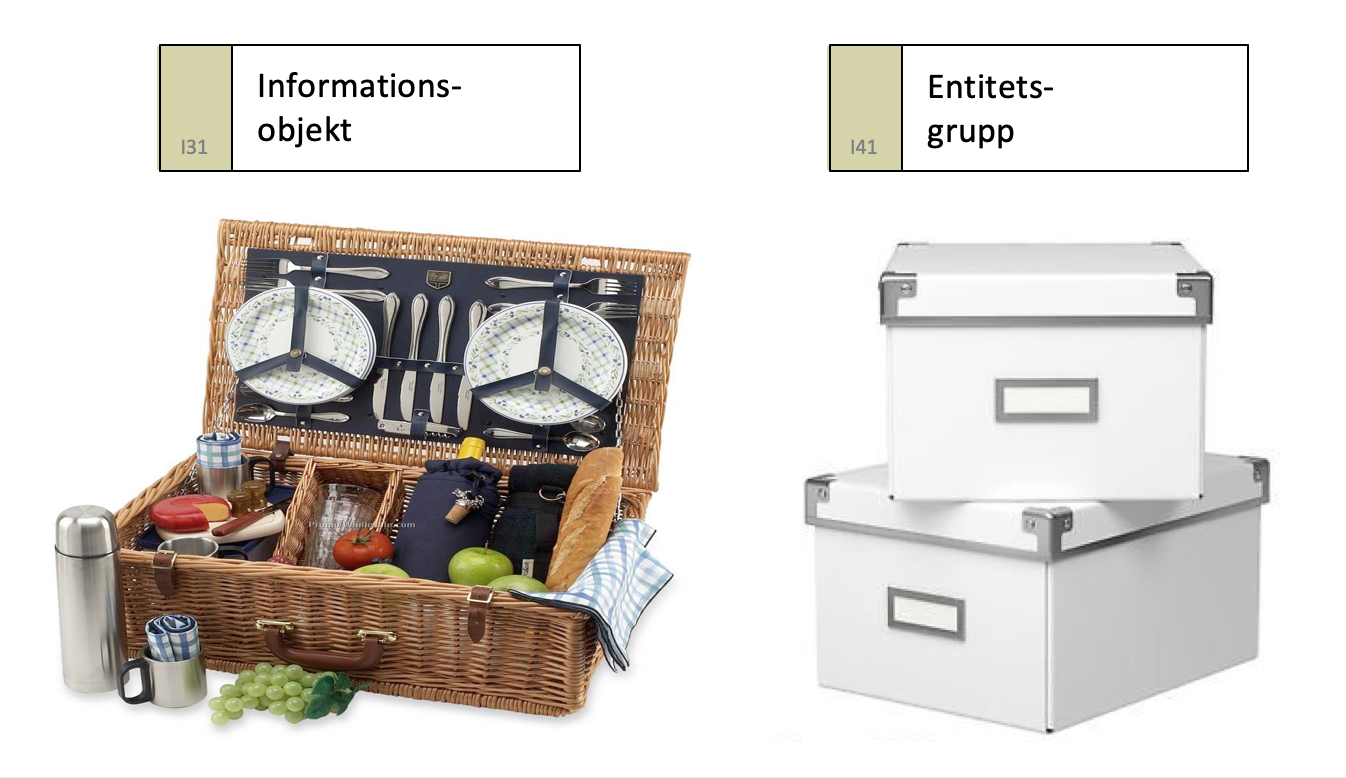
Vi att utforskar informationsarkitekturen i en verksamhet med hjälp av metaforen "hemmet". Här kan du utveckla dina kunskaper i informationsarkitektur.
I den föregående artikeln analyserades olika metaobjekt i Prime Arch för att identifiera vilken som lämpar sig bäst för informationsklassificering. Analysen visade att artefakten (I42) är det mest ändamålsenliga metaobjektet att använda. Den är tillräckligt konkret för att fånga informations behov av skydd utan att vara för detaljerad. Den ger dessutom möjlighet att fånga hur kravet på skydd varierar i olika faser.
I föregående artikel, Informationsarkitekturens principer, beskrev vi tre viktiga principer som hjälper oss att bygga en hållbar och begriplig informationsarkitektur: MECE, proportionalitet och hållbarhet.
Vi går igenom hur man kan tänka vid byggande av informationsarkitektur med utgångspunkt kring hur man hanterar information om Kund, Anställd & Leverantör.
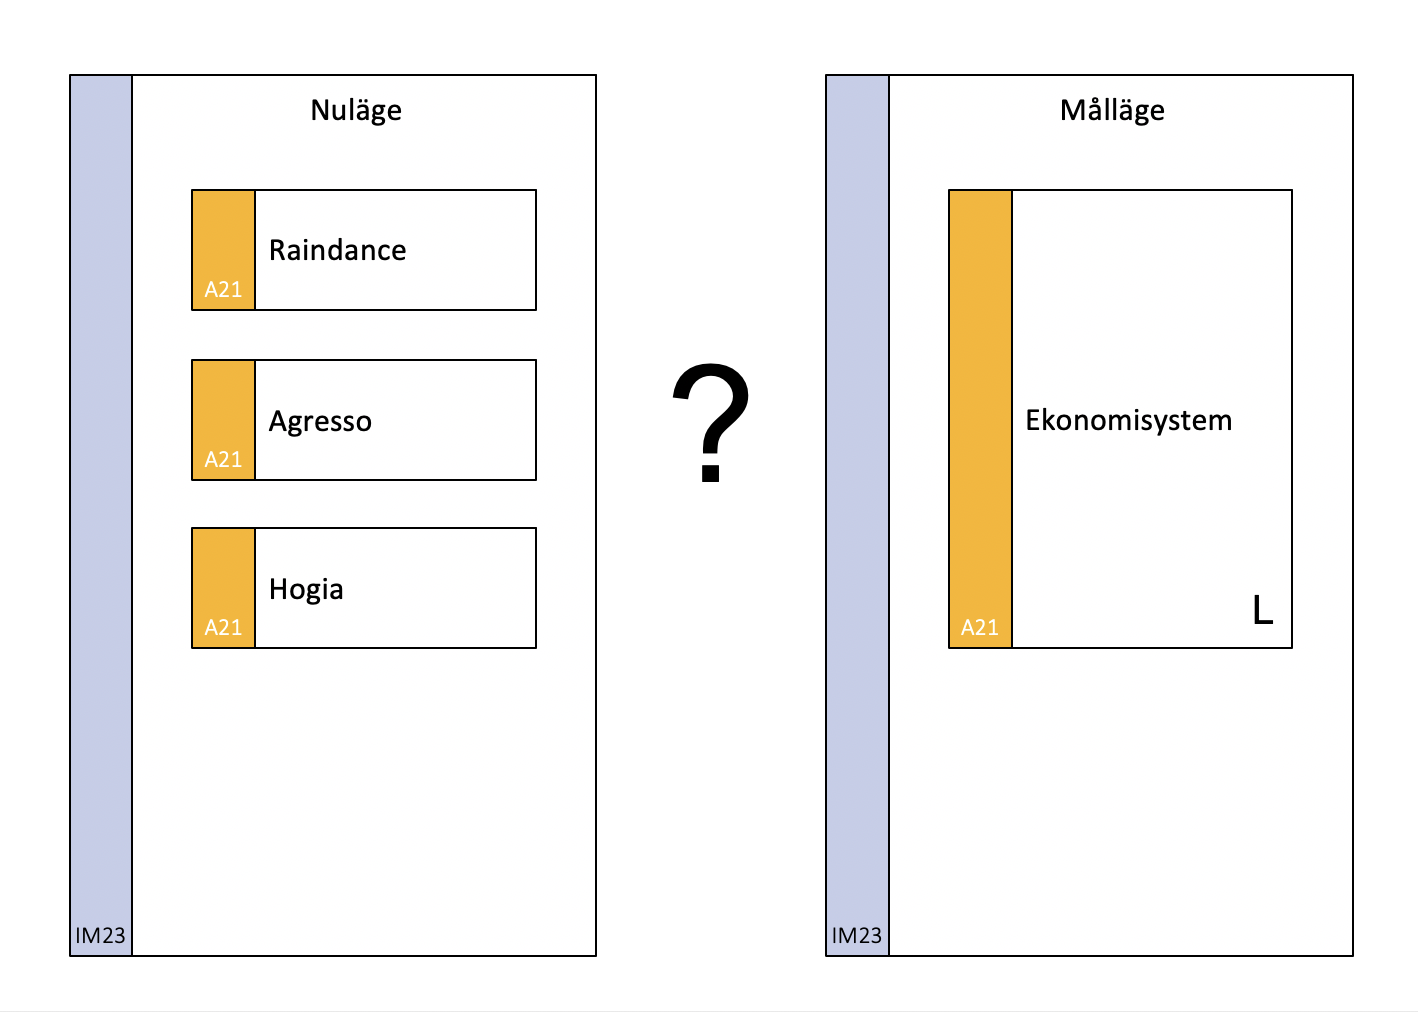
Många organisationer har flera system än de behöver. Genom att använda en logisk applikation är det relativt enkelt att klassificera befintliga applikationer.
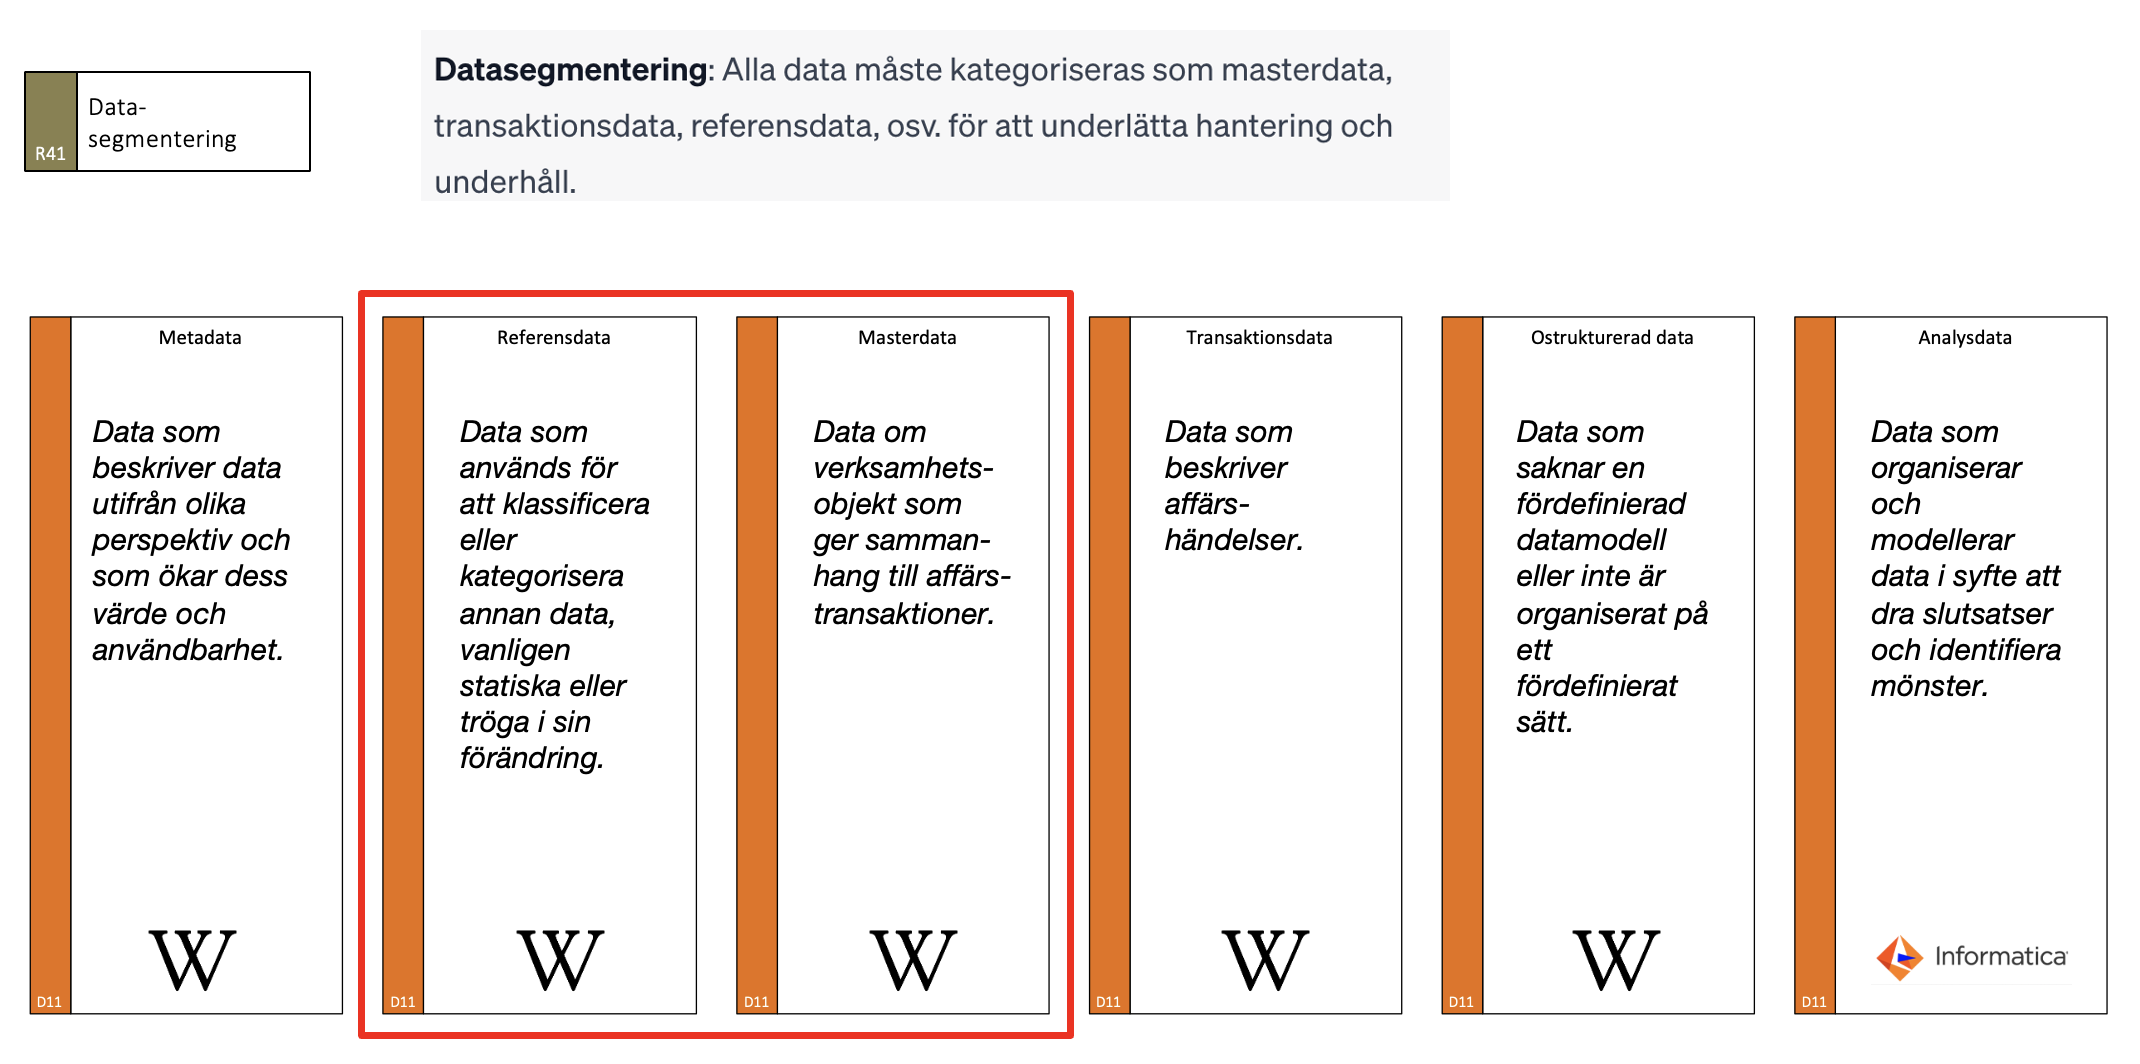
I artikeln "6 regler som styr mot en bra dataarkitektur" handlar den första regeln om "datasegmentering". Regeln beskrivs så här:
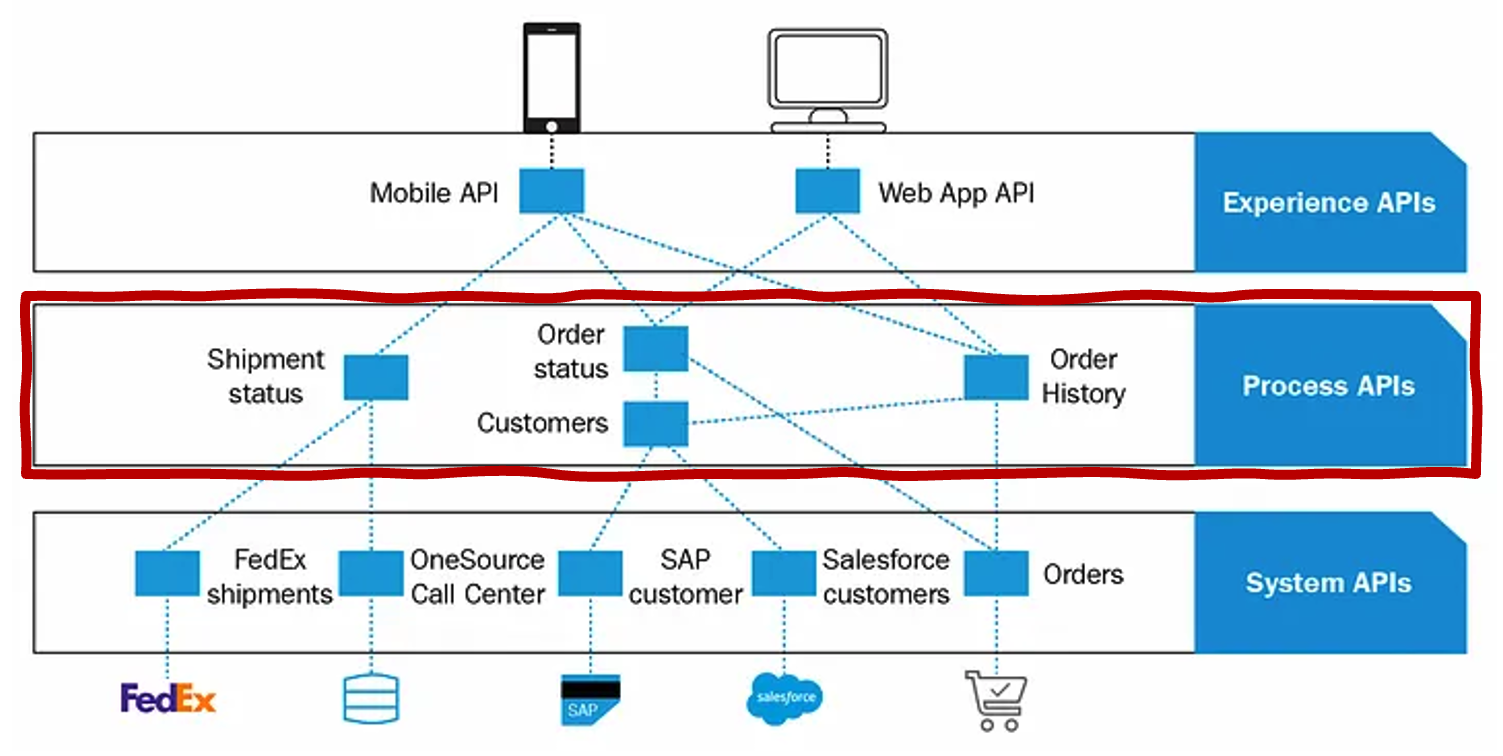
I introduktionsartikeln introducerades de olika API-lagren i API-fokuserad integration, och i föregående artikel gick vi igenom databasmodulen, där data mellanlagras och kan kompletteras manuellt. Nu fördjupar vi oss i Process API-lagret, där data från olika källor sammanställs och bearbetas för att skapa ett enhetligt informationsflöde.
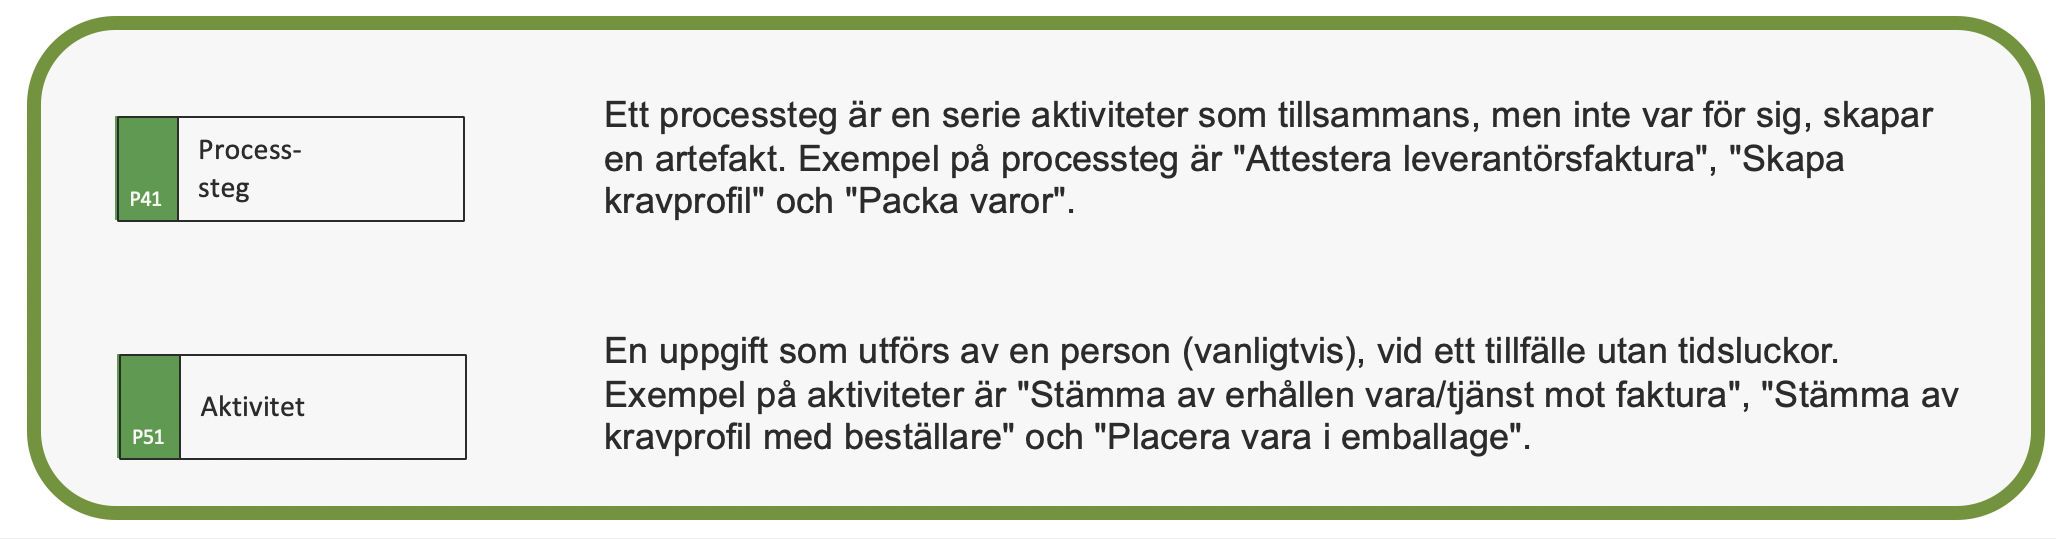
Som introduktion till processmodellering använder vi exemplet Handla Mat. Att Handla Mat är ett processteg & Plocka Vara är en aktivitet. Hur skiljs de åt?
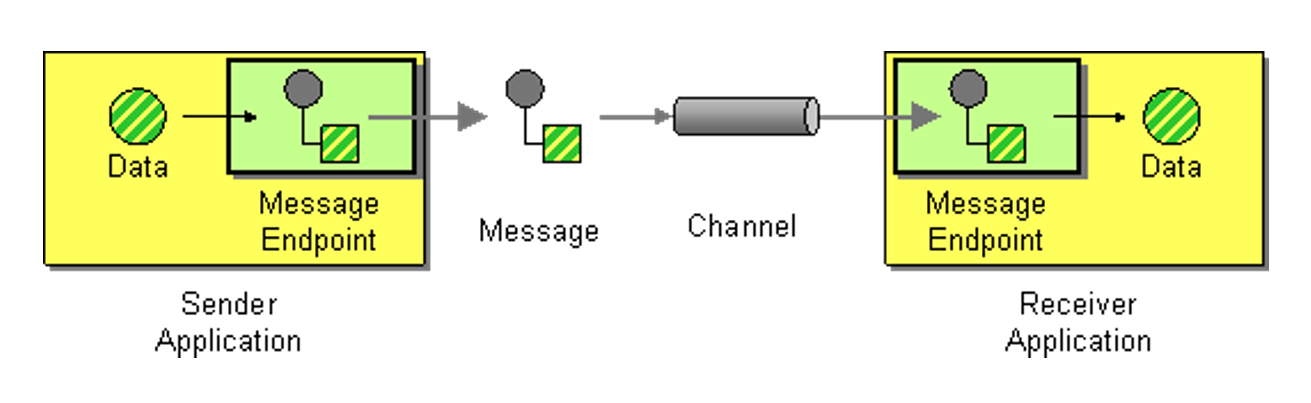
I den inledande artikeln beskrev vi API-fokuserad integration, där data flödar genom en integrationsplattform strukturerad i tre lager: System-API, Process-API och Experience-API. Denna artikel går in på System-API:ernas roll, där de fungerar som de yttersta kontaktpunkterna för inkommande och utgående data till och från plattformen.
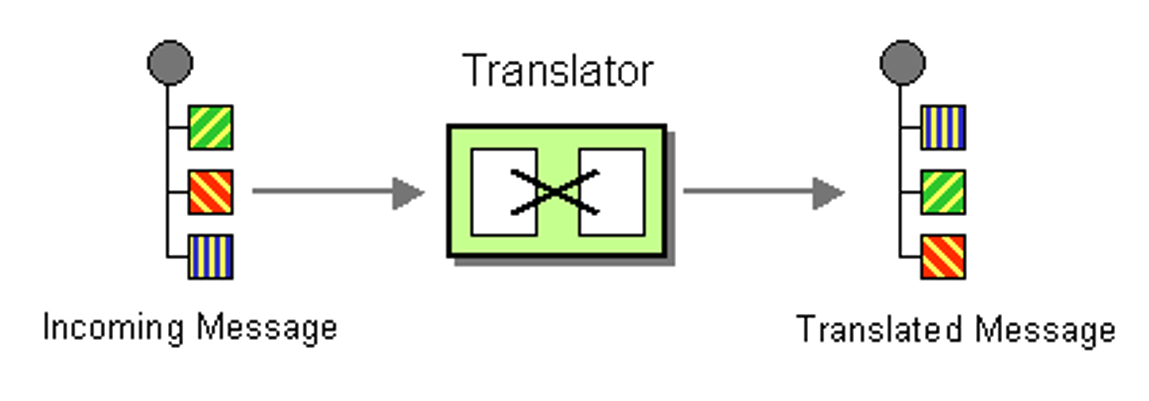
I den första artikeln gick vi igenom API-fokuserad integration och dess tre lager: System-API, Process-API och Experience-API. I den andra artikeln fördjupade vi oss i System-API och hur de fungerar som messaging endpoints mellan plattformen och externa system. Nu ska vi titta närmare på transformationsmodulen, som ansvarar för att omvandla data till en enhetlig kanonisk datamodell.
EA borde användas för att hålla klassificeringsinformation. Men för att kunna göra det krävs att vi reder ut vilket metaobjekt som är lämplig för att hålla informationen om detta. Vilket metaobjekt är egentligen mest ändamålsenligt för syftet?
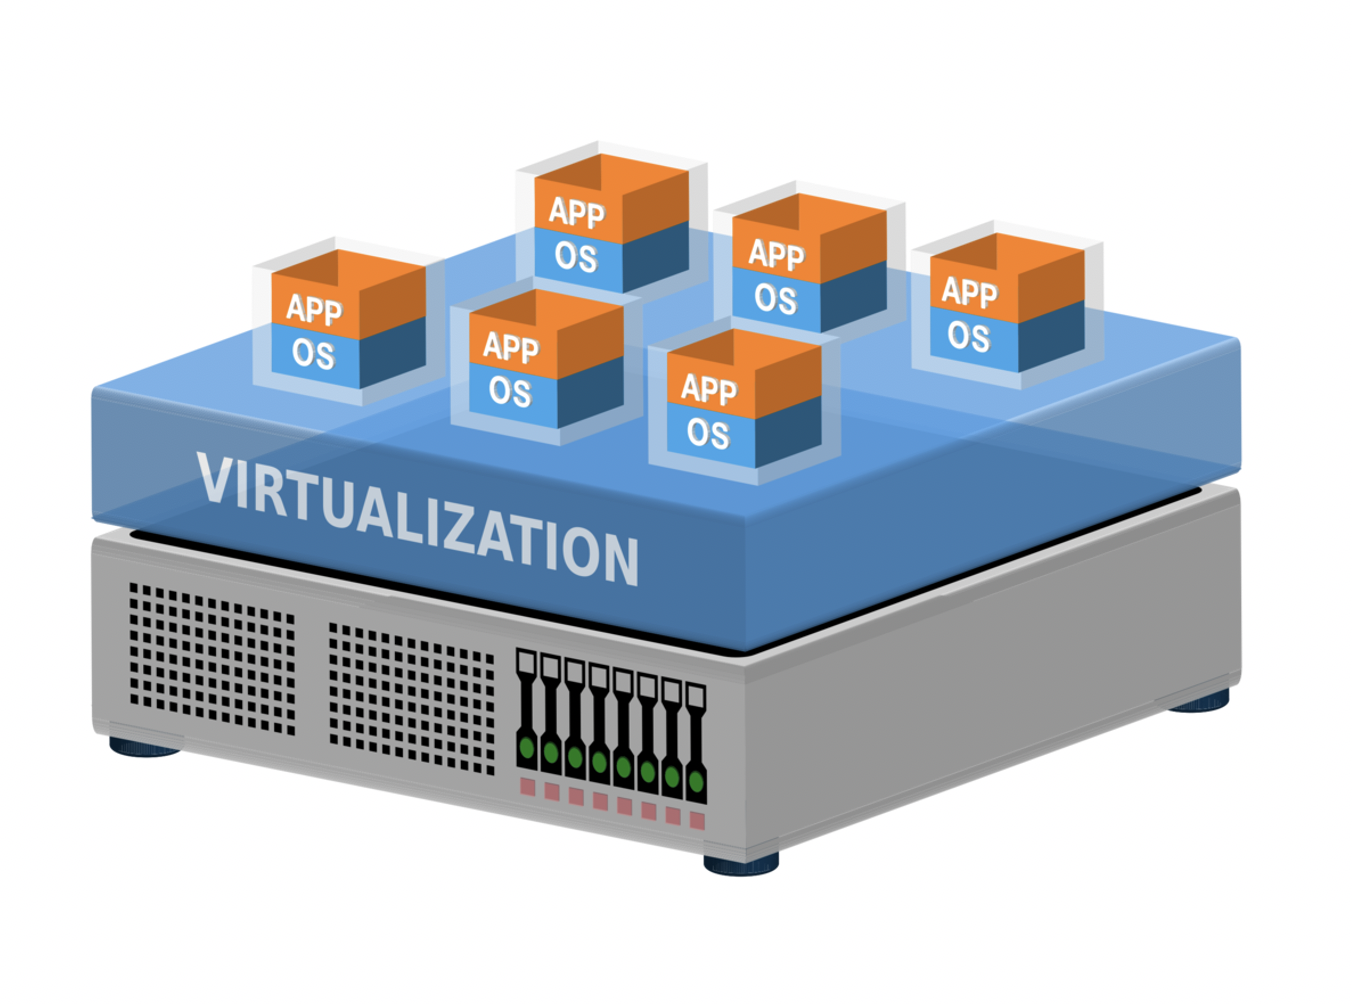
I det första användningsområdet visade vi vilken teknik som används bakom olika applikationer (länk till föregående artikel).
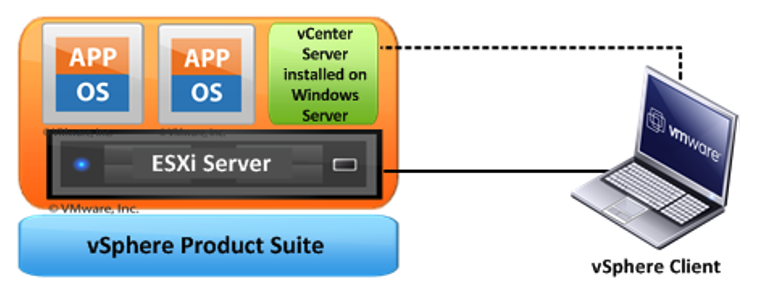
Denna artikel ska inte ses som någon reklam för en specifik programvara utan enbart som ett exempel på hur virtualisering kan modelleras i Prime Arch.
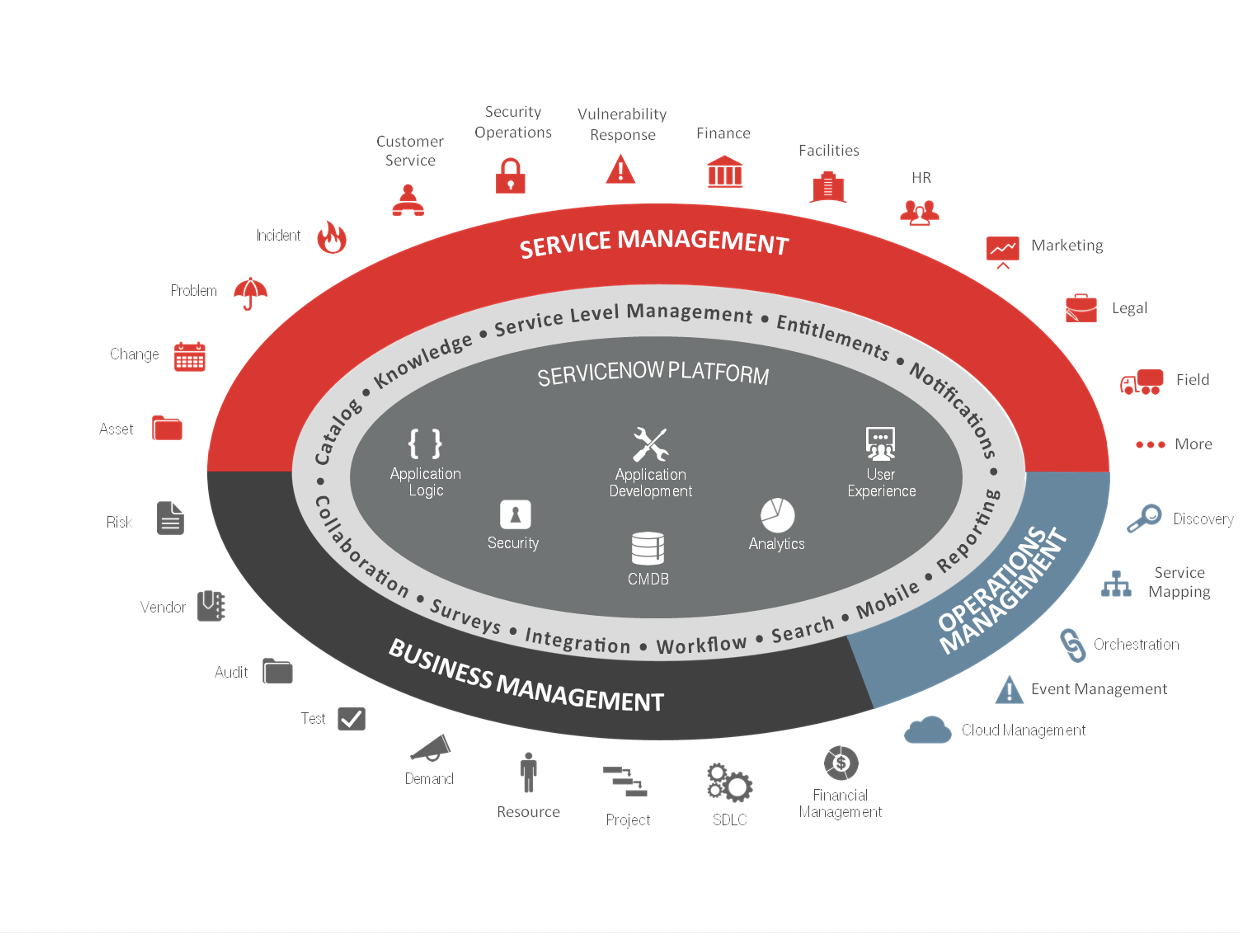
Ett område i modellering av plattform handlar om att visa vilka delar i plattformen som använts för att utveckla en applikation.
I det första området, som handlar om att visa vilken teknik som används bakom olika applikationer, används främst tre metaobjekt: