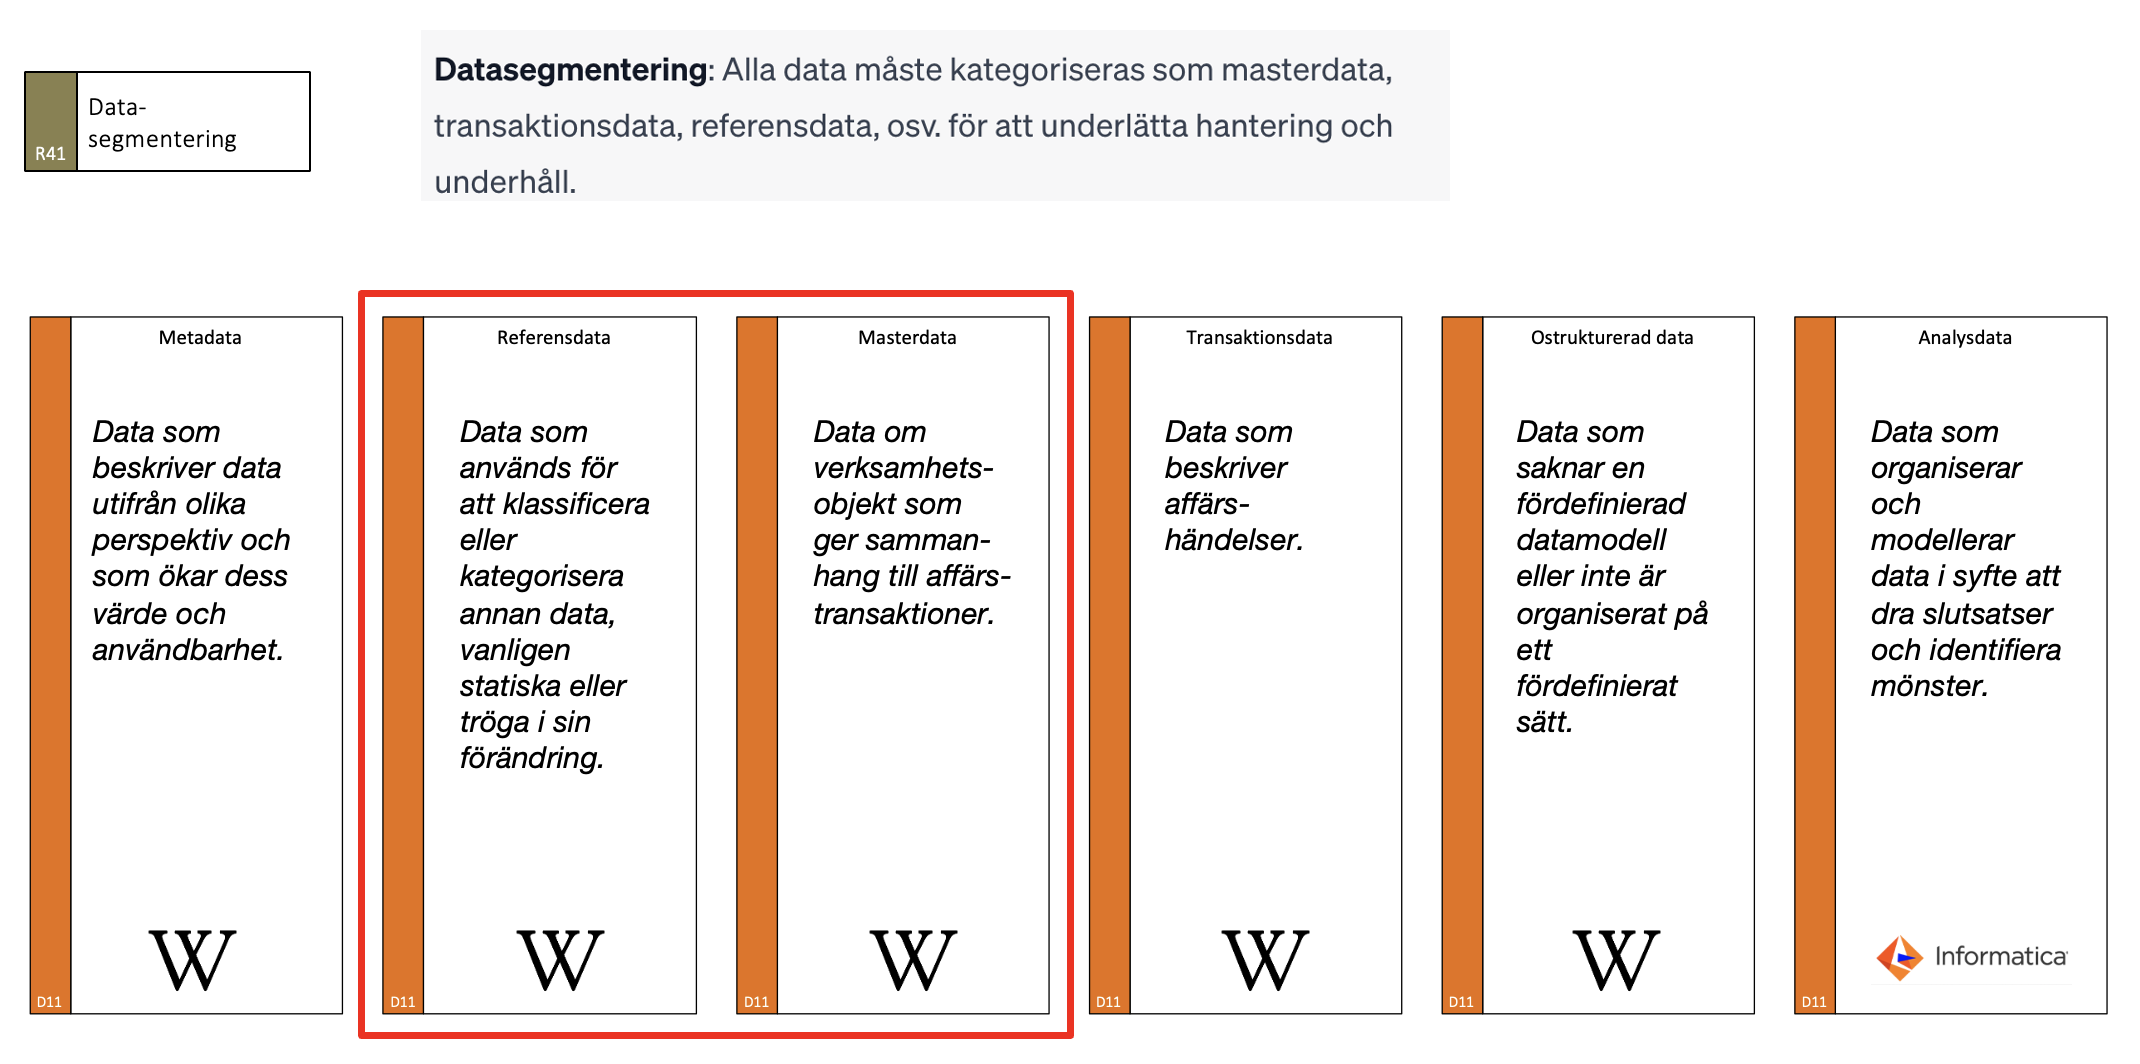
I artikeln "6 regler som styr mot en bra dataarkitektur" handlar den första regeln om "datasegmentering". Regeln beskrivs så här:
Alla data måste kategoriseras som masterdata, transaktionsdata, referensdata, osv. för att underlätta hantering och underhåll.
I artikeln "Kategorisering av data" identifieras en enkel kategoriseringsmodell för all form av data i en verksamhet. Den indelar data i sex kategorier:
- Metadata
- Referensdata
- Masterdata
- Transaktionsdata
- Ostrukturerad data
- Analysdata
I artikeln listas även fler kandidater, men detta praktikfall fokuserar på Masterdata och Referensdata. I fallet studeras sex dataentiteter (i Prime Arch D51) som vanligen återfinns i system som hanterar kunddata.
- Part (fysisk person och juridisk person)
- Kund
- Arbetsplats (plats där kunden har verksamhet)
- Land
- Kundkonto (vanlig detaljeringsnivå av kund för att styra t ex fakturering eller leveranser)
- SNI-kod (Svensk Näringsgrensindelning)
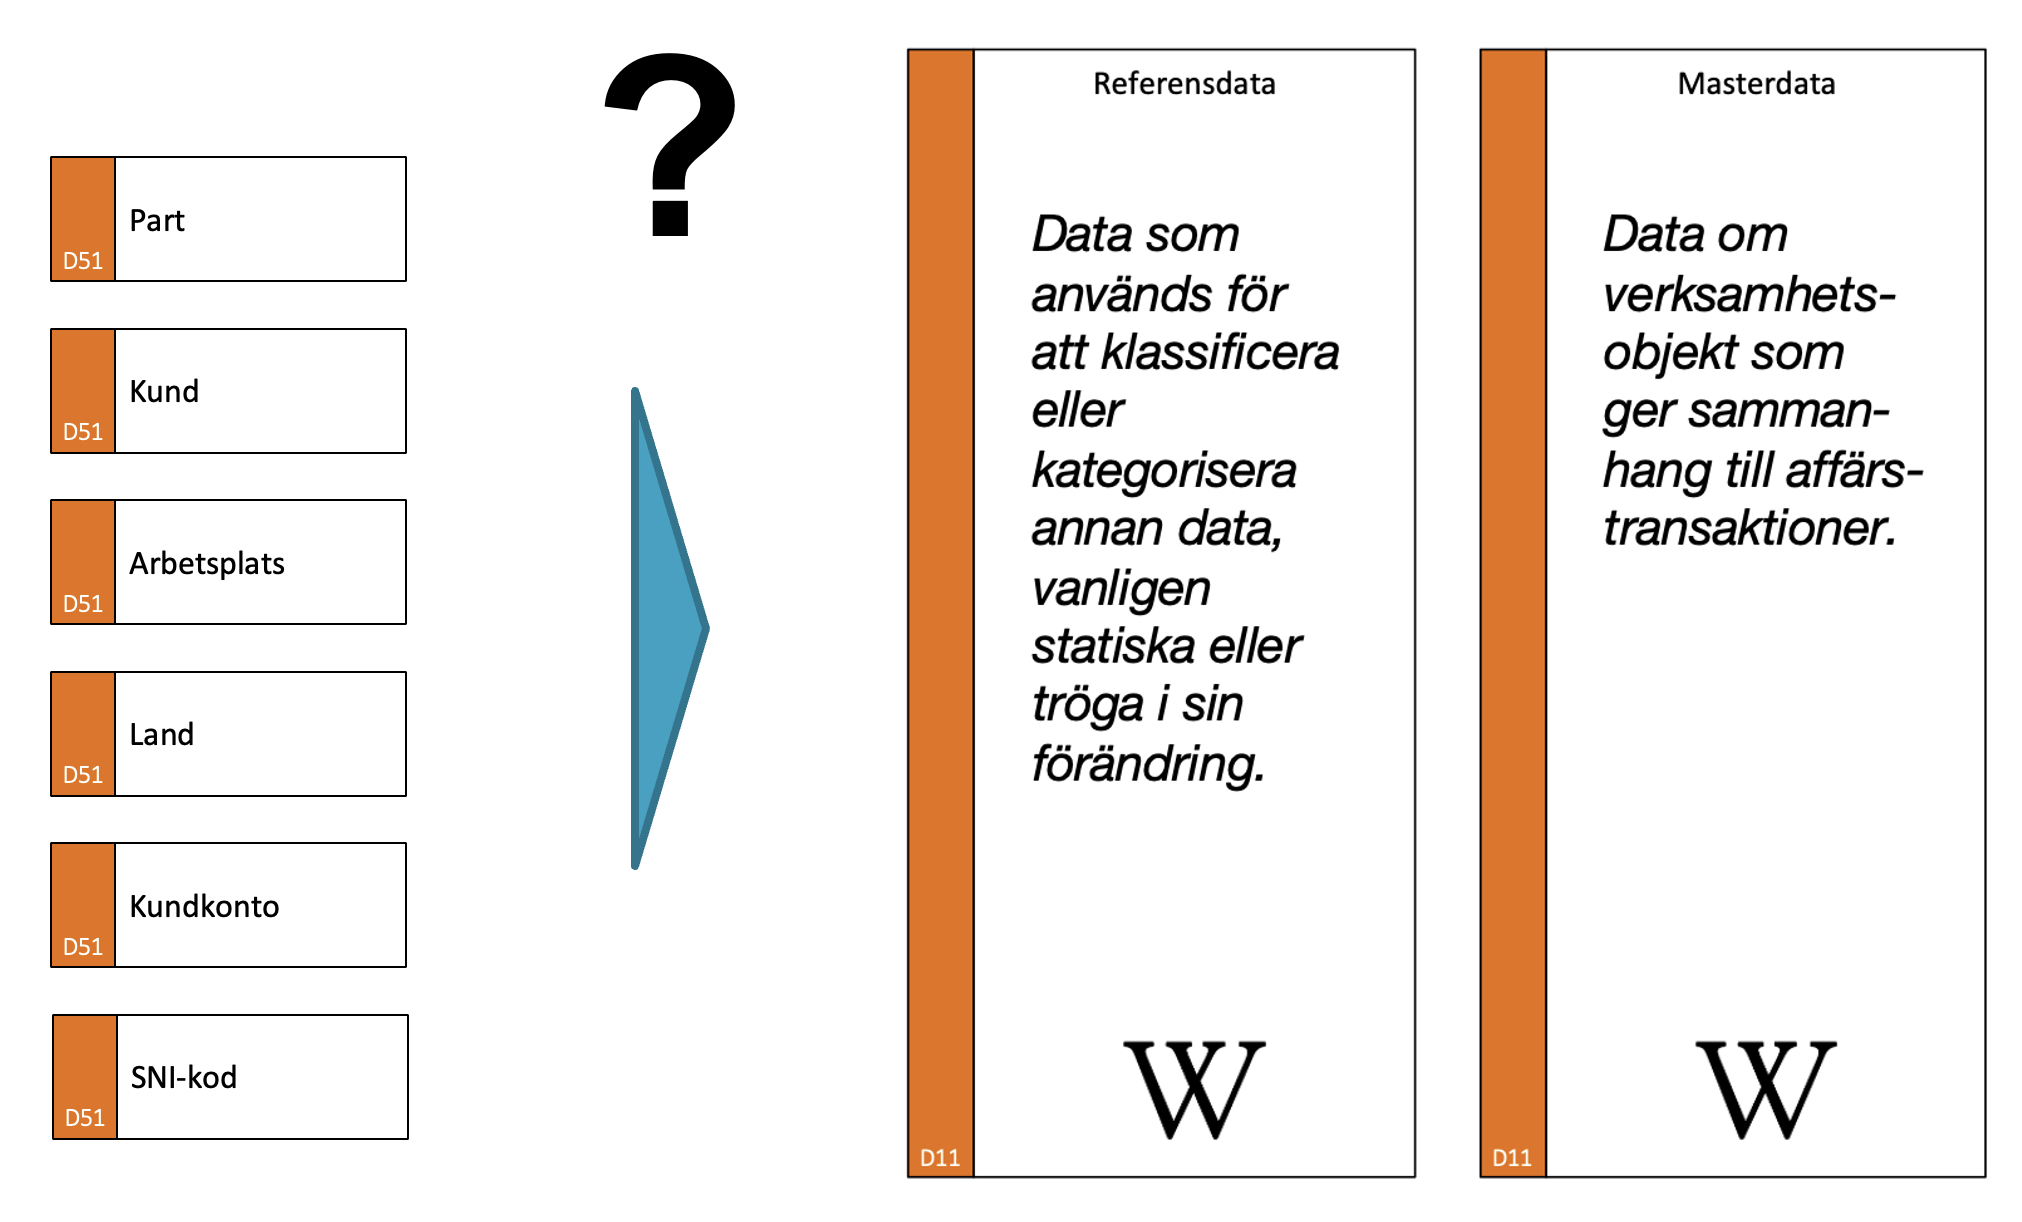
Varje dataentitet matchas mot beskrivningen av respektive datadomän (i Prime Arch D11) och resultatet av kategoriseringen visas nedan:
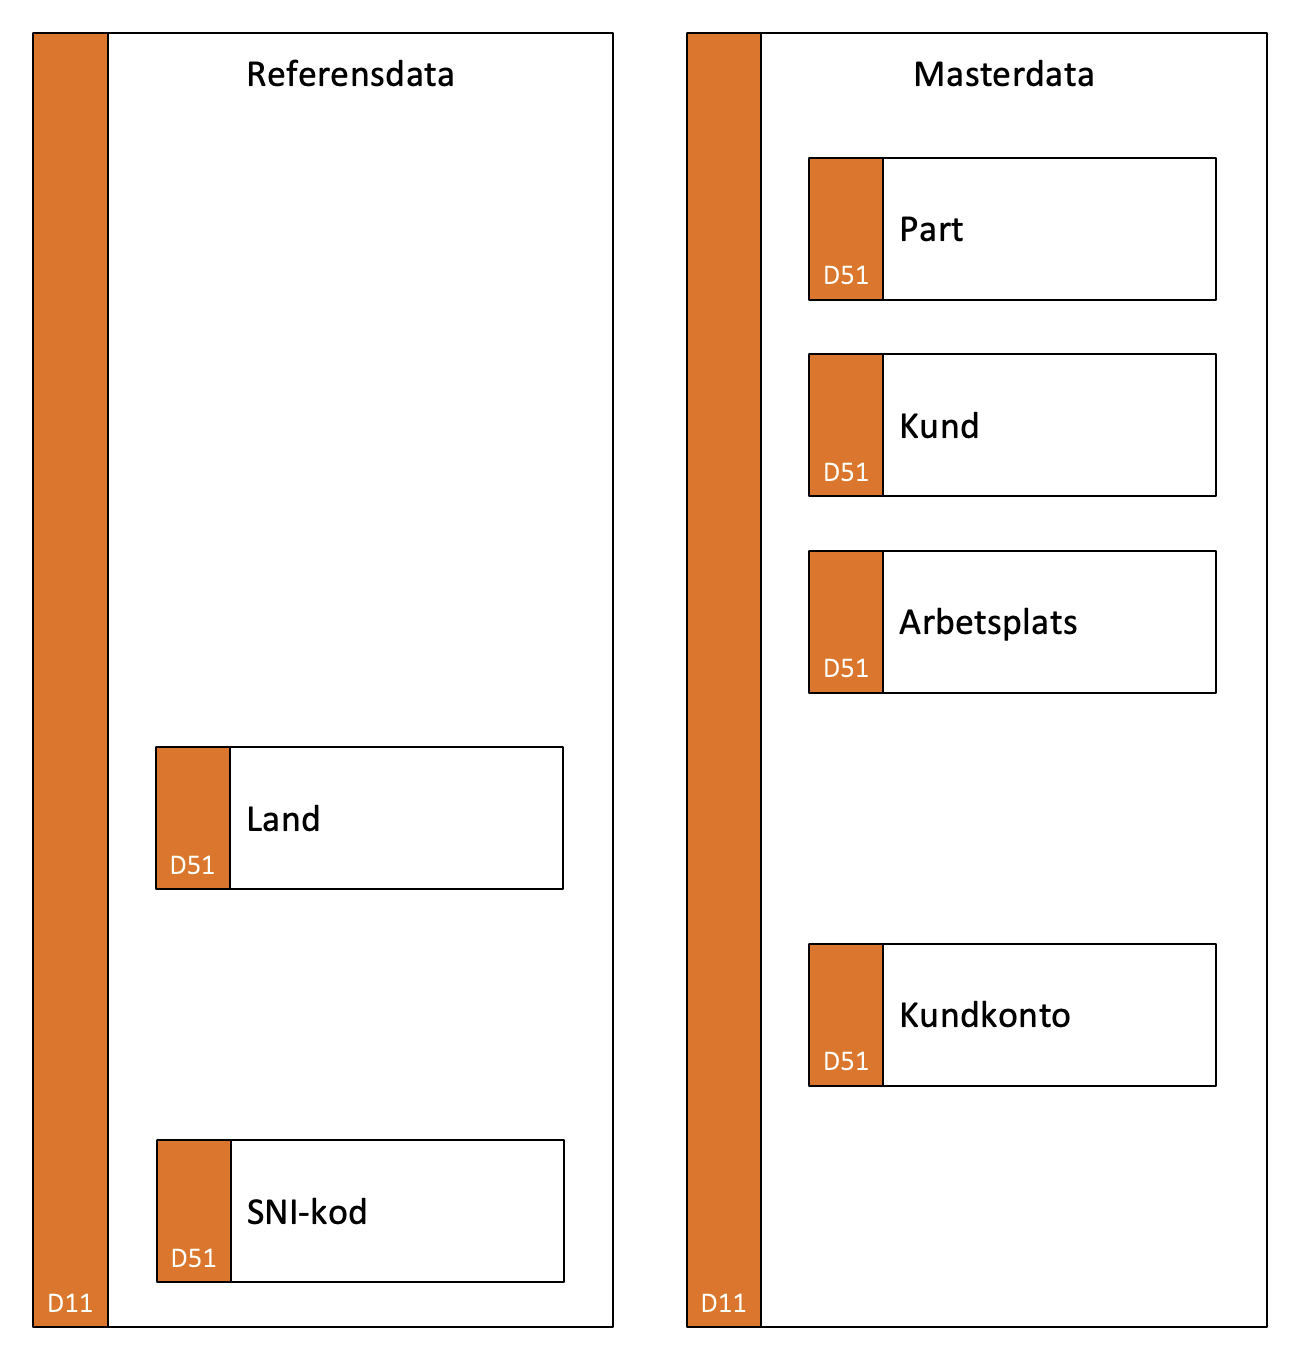
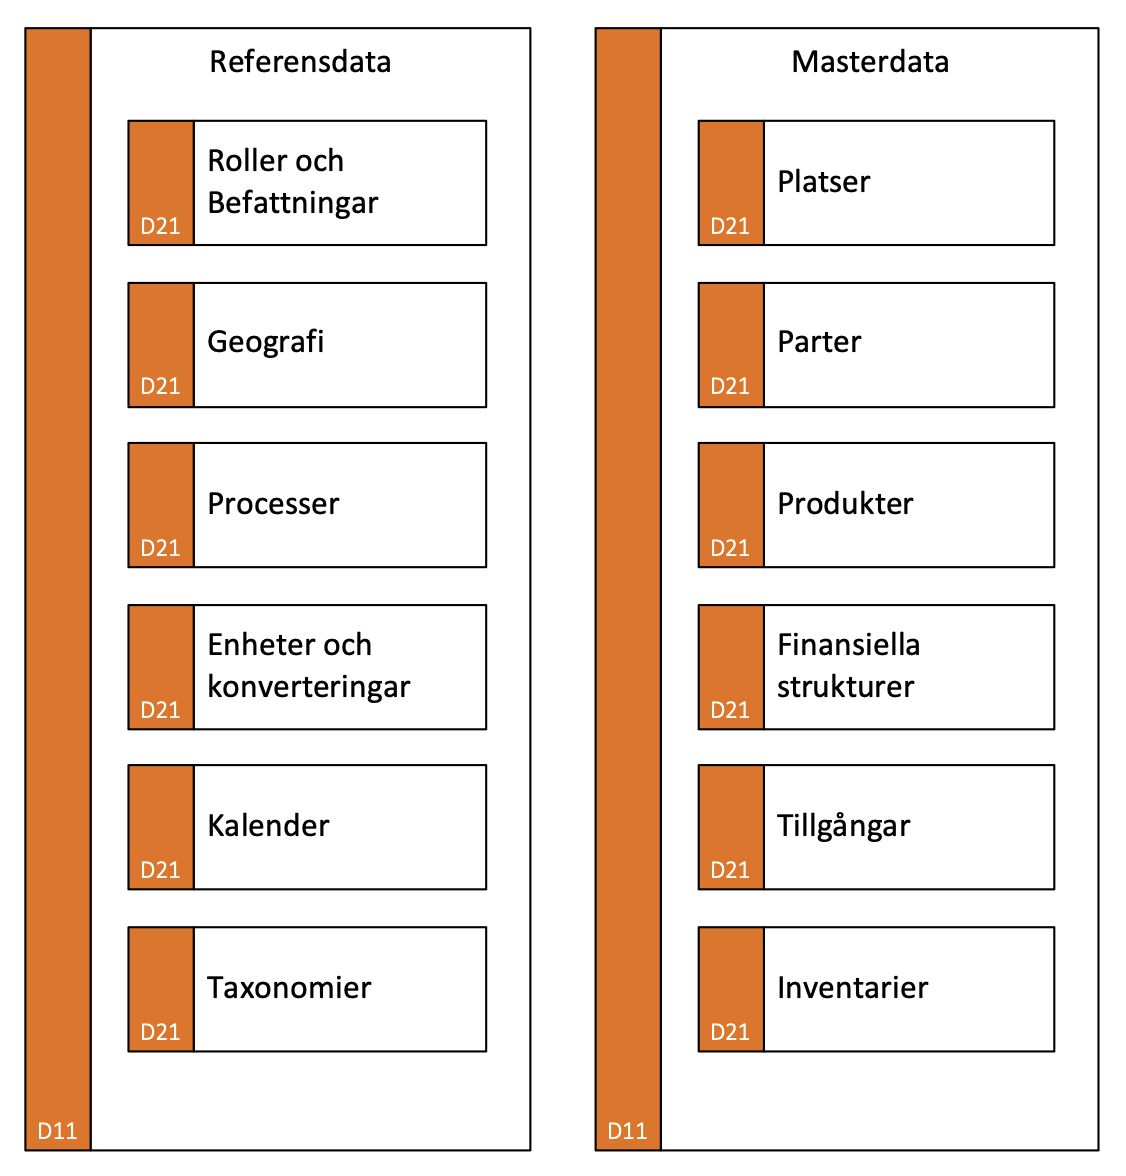
Nästa steg är att kategorisera i ytterligare en nivå, i Prime Arch kallas dessa datagrupper (D21). Samma artikel om kategorisering av data som nämns ovan beskrivs vanligt förekommande datagrupper. Referensdata och Masterdata delas vanligen in i följande datagrupper:
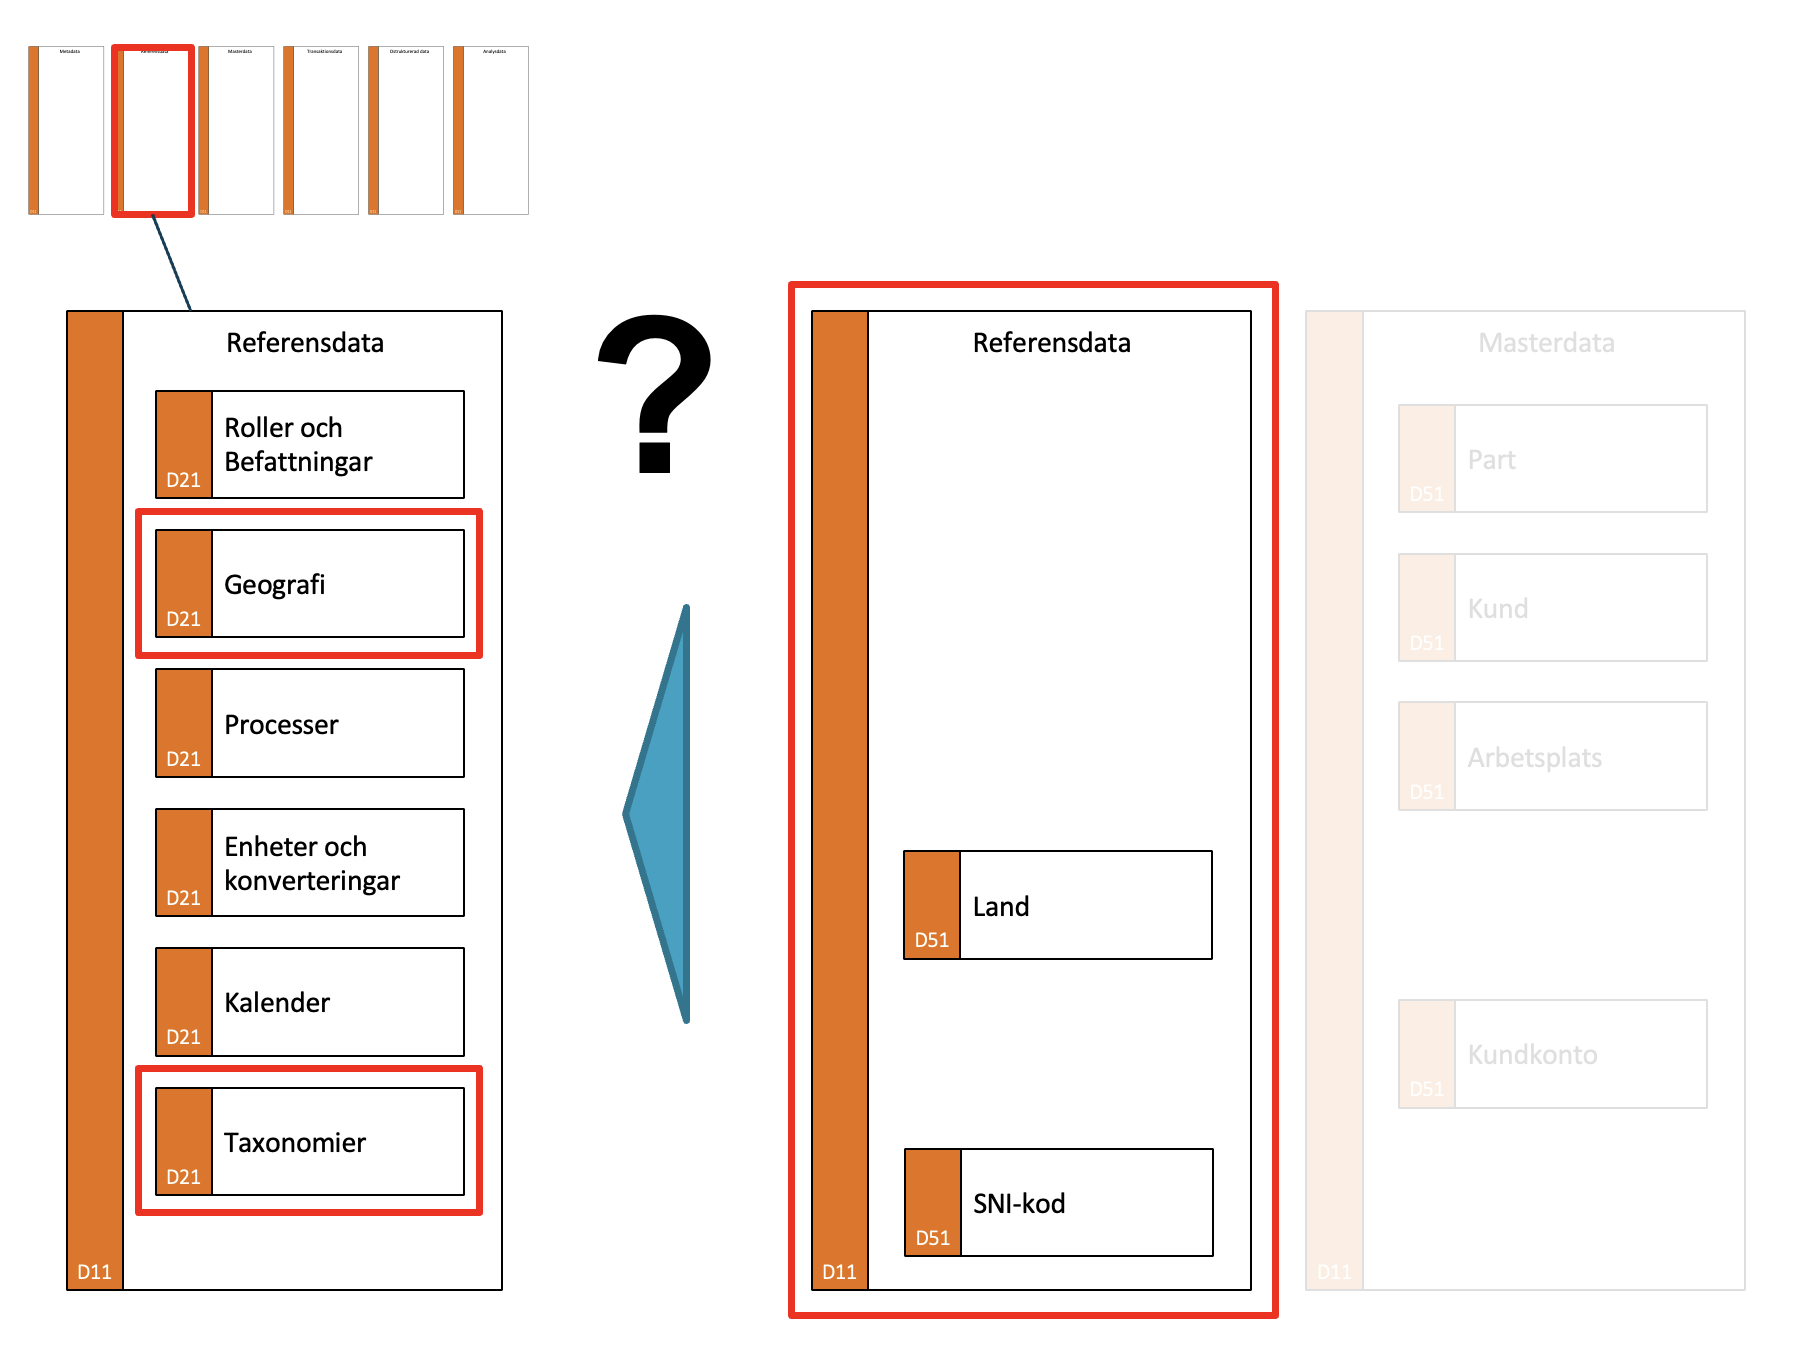
De dataentiteter som kategoriserats som referensdata matchas mot datagrupperna:
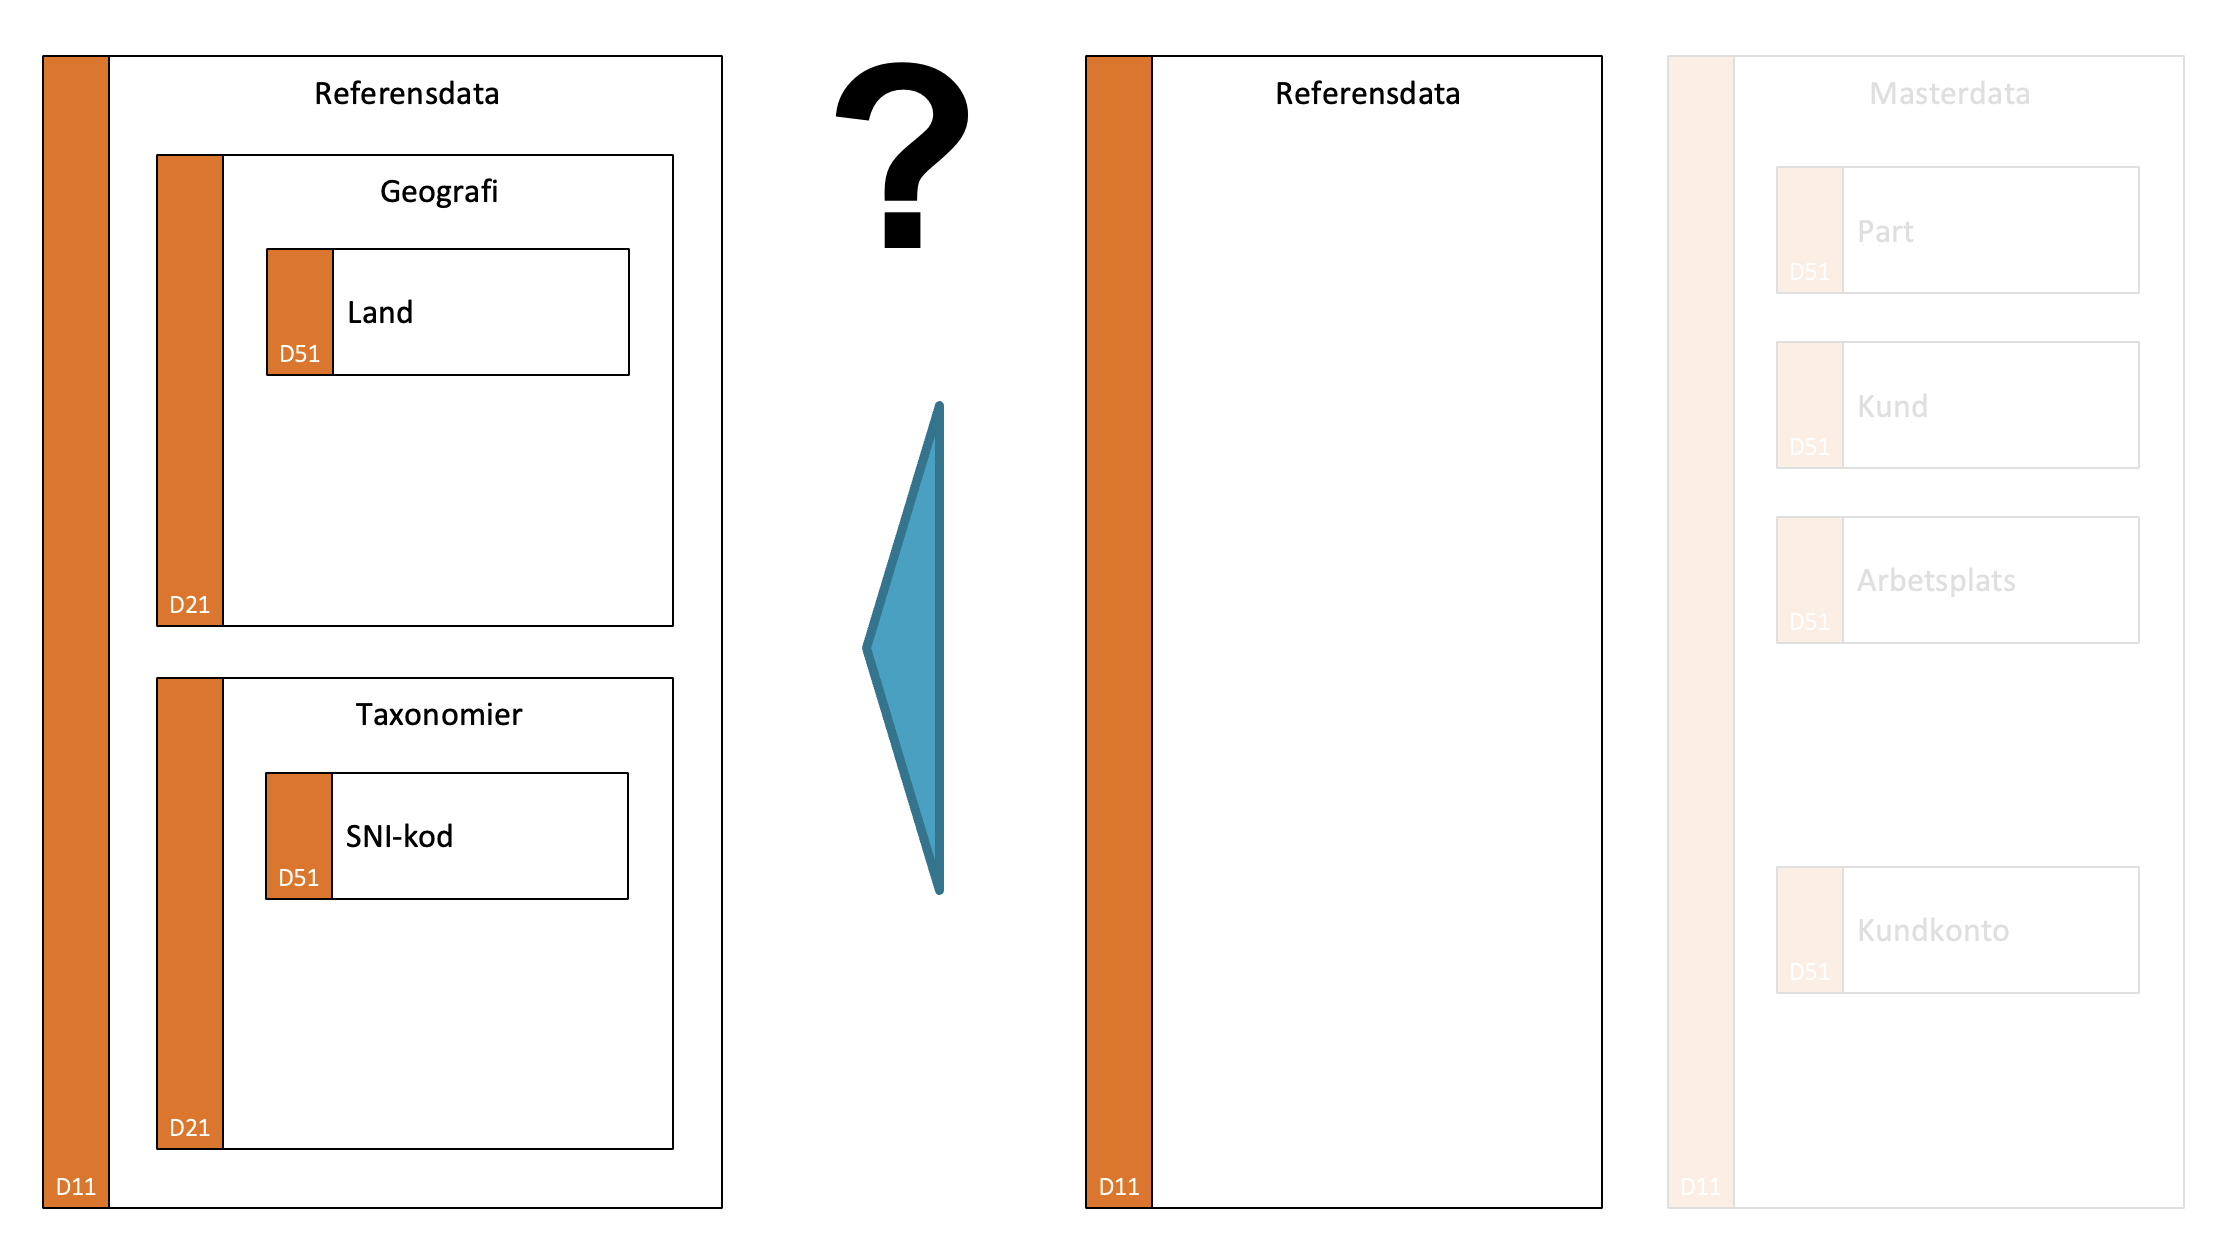
Varje dataentitet ska placeras i en datagrupp, och resultatet av kategoriseringen visas nedan:
På samma sätt ska nu dataentiteterna som kategoriserats som masterdata matchas mot datagrupperna:
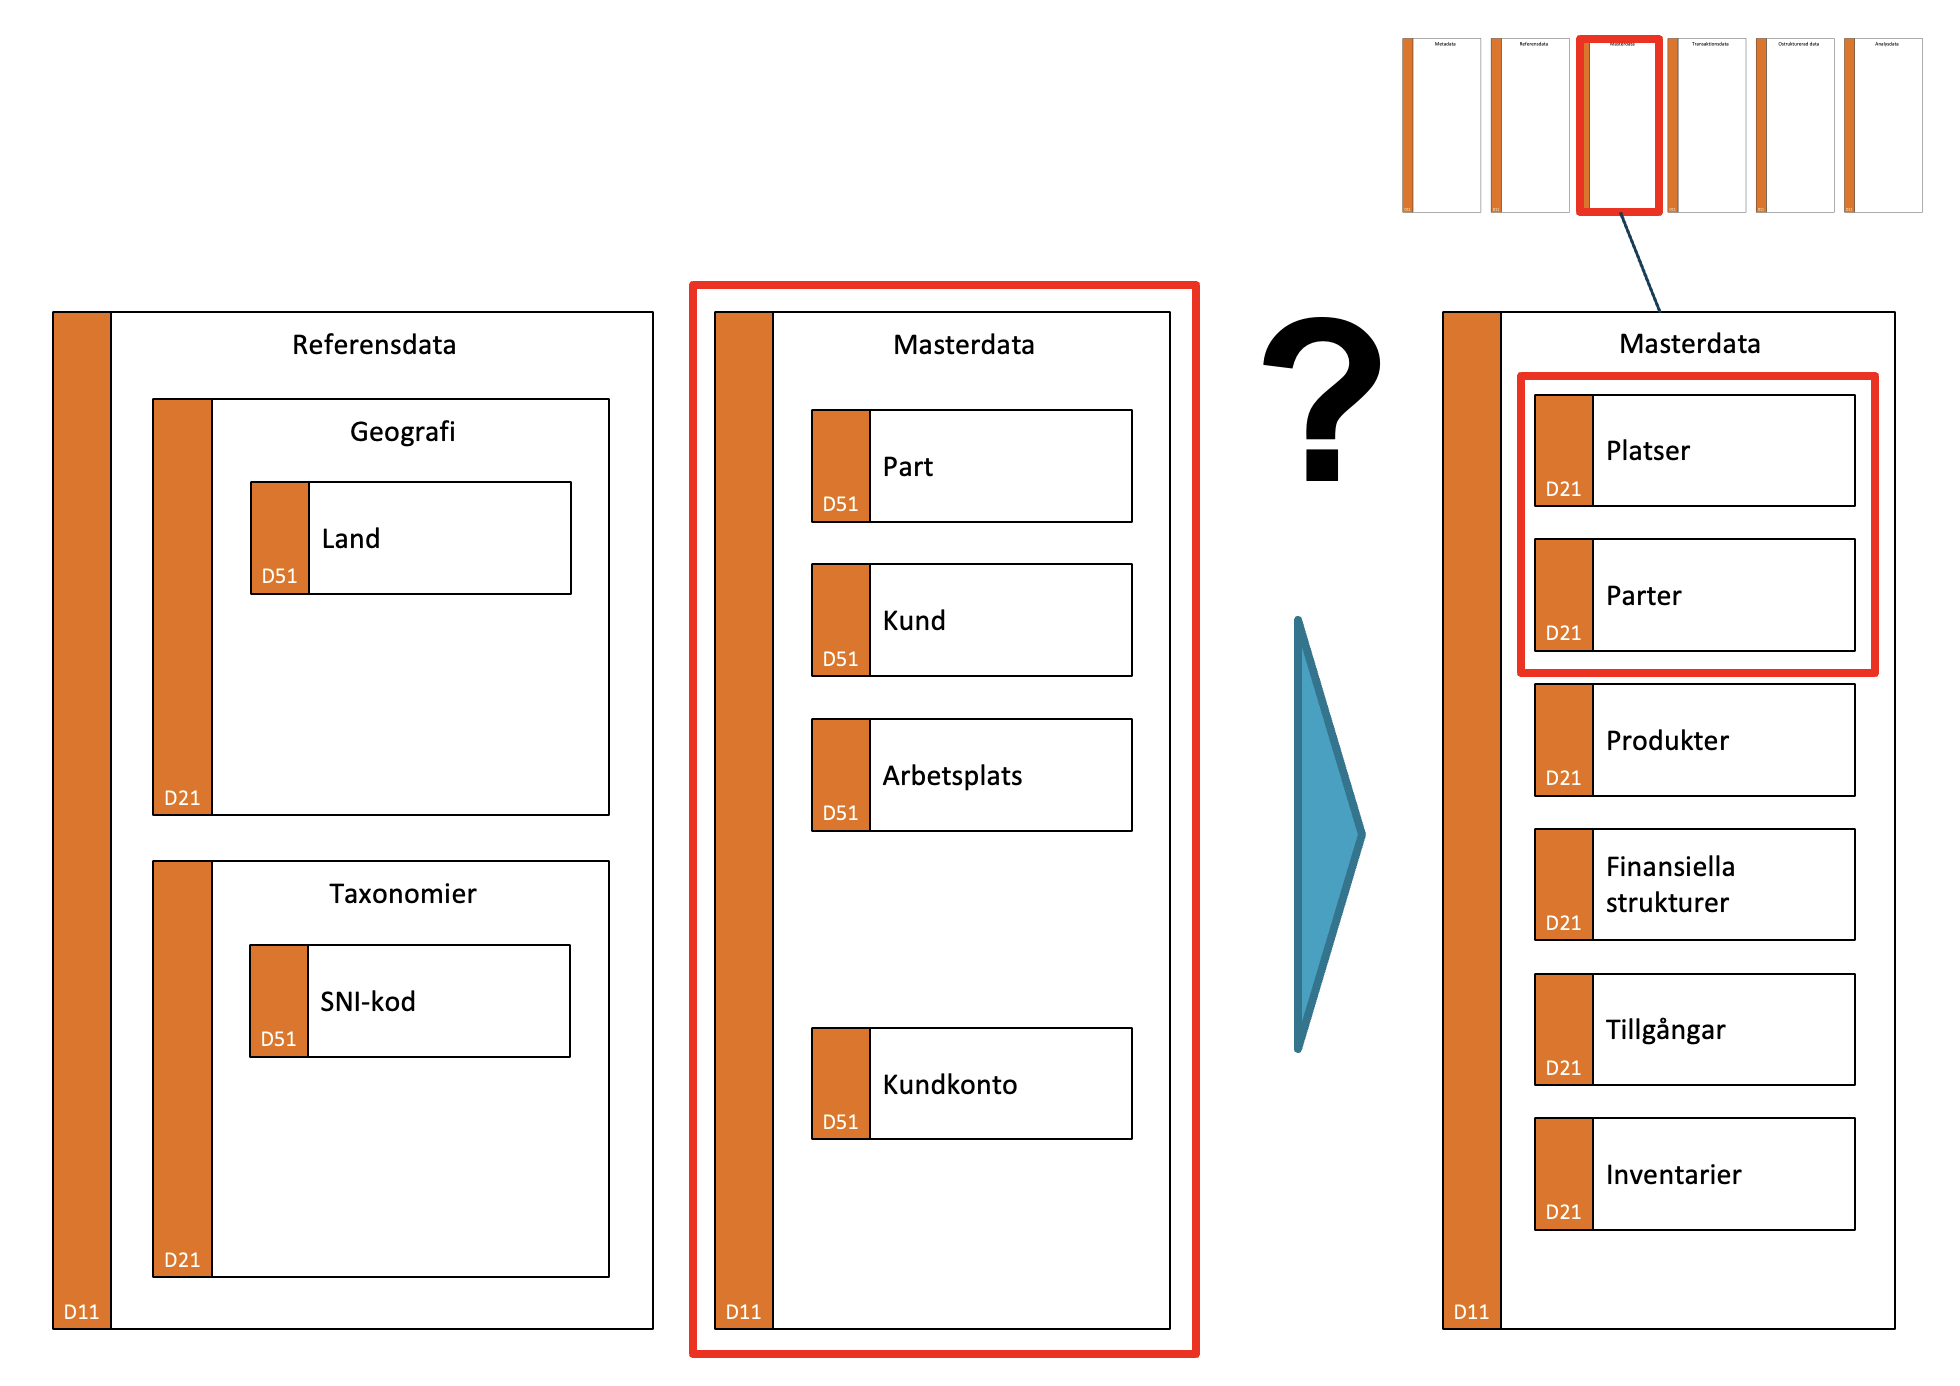
Slutresultatet av kategorisering av samtliga sex dataentiteter i två nivåer, först datadomän och därefter underliggande datagrupper ser ut så här:
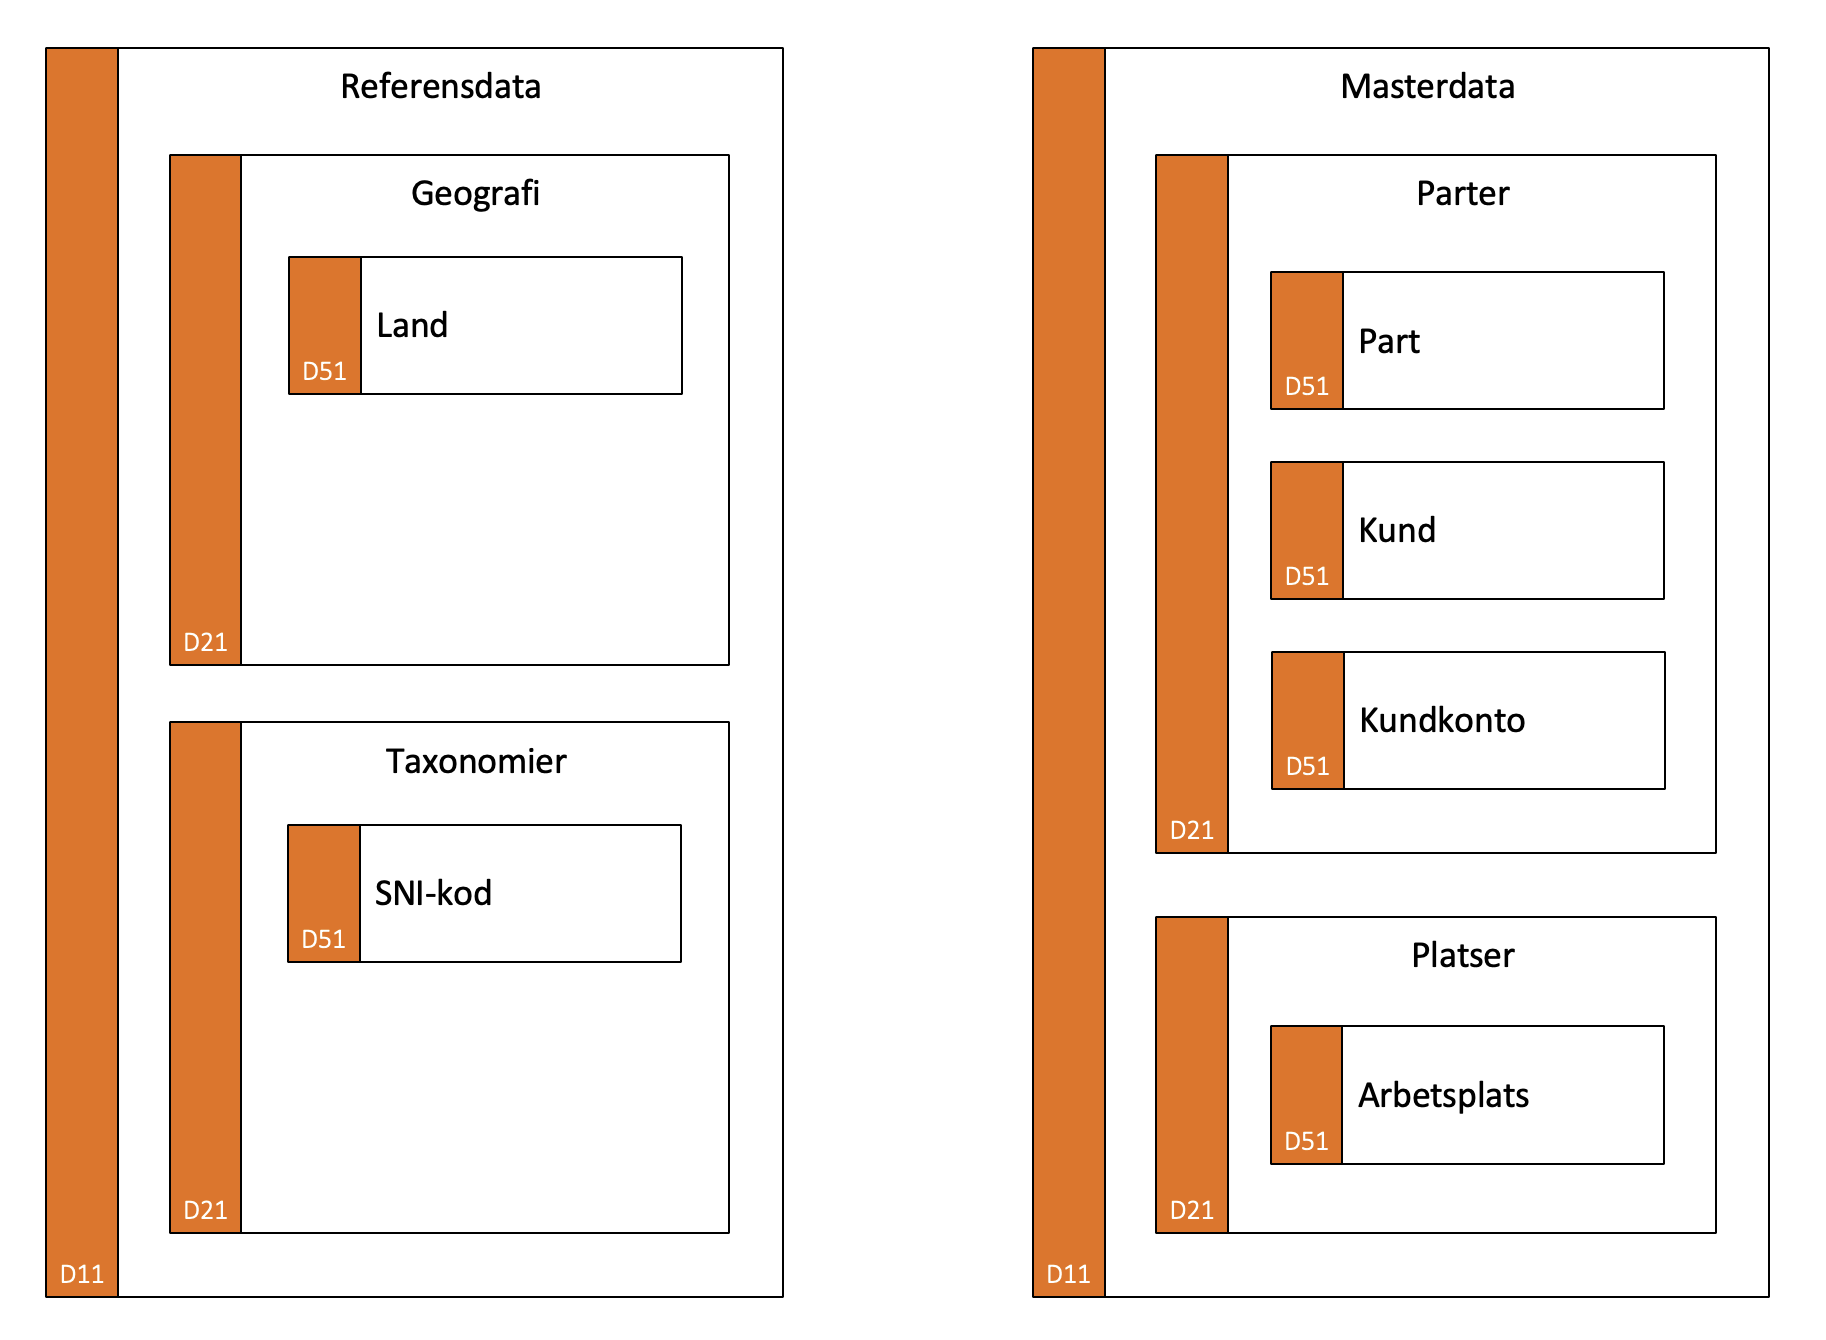
Denna kategorisering bidrar till att det blir lättare att hantera och underhålla dessa datamängder, vilket ökar effektiviteten i hela organisationen.